CI und CD (Continuous Integration und Continuous Delivery) fördern die Verlagerung nach links: Kleine Änderungen werden früh und häufig committet und durch Automatisierung geprüft. So lassen sich Probleme frühzeitig erkennen und beheben, und eure Mainline bleibt jederzeit releasebereit.

Timothy Harris
An American living in Denmark. Tim used to work for Eficode. He has more than 20 years of experience in development, operations, continuous integration, and delivery.
DevSecOps ist eine natürliche Weiterentwicklung
DevOps (Development und Operations) ist eine Reihe von Praktiken und kulturellen Prinzipien, die Prozesse zwischen Entwicklung und Betrieb automatisieren und integrieren. Es ist eine natürliche Weiterentwicklung der mit CI/CD eingeführten Ansätze.
DevSecOps (Development, Security und Operations) ist ein Ansatz für Kultur, Automatisierung und Plattformdesign, der Sicherheit während des gesamten Entwicklungszyklus als gemeinsame Verantwortung integriert. Daher ist es nur folgerichtig der nächste Schritt in der Entwicklung unserer Art, Software zu entwickeln.
DevSecOps umfasst viele Bereiche
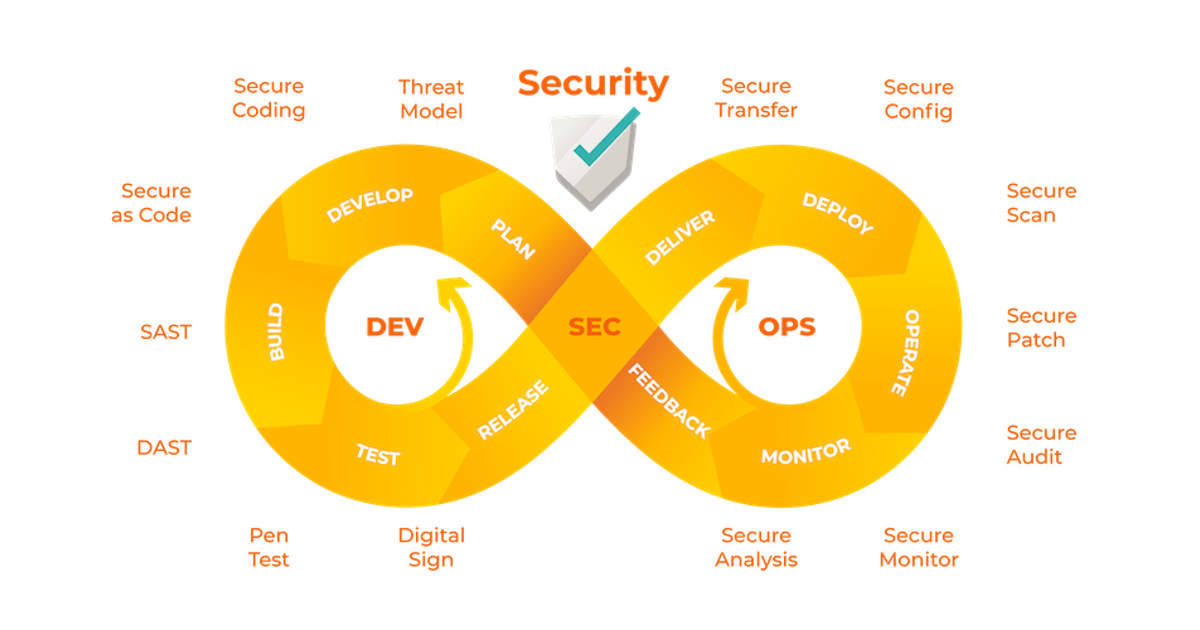
Bei DevSecOps geht es um mehr als nur das Scannen nach Schwachstellen. Schaut euch die folgende Grafik des SANS Institute an.

Quelle: https://twitter.com/sanscloudsec/status/968590339371126784
Wie ihr seht, umfasst eine sichere DevOps-Toolchain alles von statischen Anwendungssicherheitstests (SAST) über dynamische Anwendungssicherheitstests (DAST) bis hin zu Sicherheitsaudits und Monitoring – und viel, viel mehr. DevSecOps kann etwas überwältigend sein, denn es gibt viel zu bedenken und viele Bereiche abzudecken.
Aus Sicht der Automatisierung ist die Suche nach Schwachstellen in euren CI/CD-Pipelines jedoch ein guter Ausgangspunkt.
Das Scannen eures Codes nach Schwachstellen, Fehlern oder Sicherheitslücken ist ein wesentlicher Bestandteil effektiver Softwaresicherheit. Es ist der natürliche Ausgangspunkt und der Bereich, den ihr in einer sich ständig wandelnden Bedrohungslandschaft am besten kontrollieren könnt.
Untersuchungen des US-Heimatschutzministeriums haben ergeben, dass 90 % der Sicherheitsvorfälle auf die Ausnutzung von Fehlern in Software zurückzuführen sind.
CI/CD-Pipelines kommen früh im Entwicklungsprozess zum Einsatz. Sie sind ein wichtiges Kontrolltor für Continuous Delivery, erfordern für den Einstieg in der Regel keine großen Investitionen und lassen sich auf einer Vielzahl von CI-Servern implementieren. Wenn ihr sie erfolgreich in einer Pipeline ausführen könnt, stehen die Chancen gut, dass ihr sie irgendwann in euer Build-System integrieren könnt. Das bedeutet im Grunde, so weit wie möglich nach links zu verschieben.
Pipelines eignen sich auch hervorragend, um verschiedene Tools zu bewerten, ohne bestehende Entwicklungsprozesse und Entwickler zu beeinträchtigen – zumindest bis ihr passende Tools und Technologien gefunden habt.
Der Rest dieses Blogs konzentriert sich daher hauptsächlich auf die Automatisierung der Schwachstellenerkennung in CI/CD-Pipelines.
Behaltet das Ziel im Blick
Technologie-Stacks unterscheiden sich von Unternehmen zu Unternehmen erheblich. Es wäre unmöglich, jeden denkbaren Stack abzudecken. Wenn ihr bei der Softwareentwicklung jedoch einigermaßen modern aufgestellt seid, ist es für euch wahrscheinlich sinnvoll, das Scannen nach Schwachstellen in euren Pipelines für die folgenden Bereiche zu implementieren.
Quellcode auf Schwachstellen analysieren
Wo sollte man sonst anfangen, wenn nicht bei sicheren Programmierpraktiken? Pull Requests/Code Reviews und Coding Guidelines sind natürlich eine große Hilfe bei der Umsetzung sicherer Programmierpraktiken. Doch Entwickler sind Menschen, und Fehler passieren.
Außerdem verändert sich die Bedrohungslandschaft ständig, und was einst als sichere Programmierpraxis galt, muss es nicht dauerhaft bleiben. Die automatisierte Codeanalyse mit einem Tool oder einer Technologie, die mit der sich ständig wandelnden Bedrohungslandschaft Schritt halten kann, ist der nachhaltigere und ganzheitlichere Ansatz.
Abhängigkeiten von Drittanbietern auf Schwachstellen analysieren
Die Abhängigkeitsgraphen von Anwendungen sind tiefer denn je, und die Nutzung von Open-Source-Software ist im Vergleich zu vor gerade einmal fünf Jahren stark gestiegen.
Ich habe eine ältere Studie (2014) von Contrast Security gelesen, laut der sich die Downloads von Komponenten innerhalb von zwei Jahren von 6 auf 13 Milliarden verdoppelt haben. Das ist ein rasantes Wachstum, aber absolut glaubwürdig. Ich würde sogar sagen, dass Open-Source-Abhängigkeiten von Drittanbietern in der heutigen Software allgegenwärtig sind.
In letzter Zeit gab es einige stark beachtete Angriffe auf die Software-Lieferkette. Es ist deutlich geworden, dass Abhängigkeiten von Drittanbietern erhebliche Risiken durch Schwachstellen bergen und Teil jeder Schwachstellenerkennung sein sollten, die ihr durchführt.
Container-Images auf Schwachstellen analysieren
Habt ihr schon einmal den Ausdruck „Software frisst die Welt“ gehört? Manchmal fühlt es sich so an, als würden Container die Softwareentwicklung fressen. Und das aus gutem Grund.
Die Möglichkeit, ein standardisiertes Paketformat zu nutzen und gleichzeitig eine unveränderliche Umgebung für die Ausführung unserer Software bereitzustellen, ist in vielerlei Hinsicht ein großer Fortschritt. Doch wie bei jedem Fortschritt gibt es auch hier einiges zu beachten:
Während der Build-Zeit können anfällige Bibliotheken zu einem Image hinzugefügt werden.
Da Images schichtweise erstellt werden, können Schwachstellen verschleiert und nur schwer erkannt werden.
Die unterste Schicht eines Images enthält ein Base Image, das ein Betriebssystem repräsentiert. Wie jedes Betriebssystem kann es Schwachstellen aufweisen.
Der Prozess, in dem ein Container ausgeführt wird, verfügt möglicherweise über erhöhte Berechtigungen, die er nicht benötigt.
Das bedeutet nicht, dass ihr keine Container verwenden solltet. Scannt vielmehr eure Images. So könnt ihr Schwachstellen in eurer Software und in der Umgebung erkennen, in der sie ausgeführt wird, wenn ihr alles als einzelnes Paket bereitstellt.
Infrastructure as Code (IaC) auf Schwachstellen analysieren
Mit der zunehmenden Verbreitung von DevOps-Praktiken und -Kultur wird es immer üblicher, Infrastruktur als Code zu definieren.
Infrastructure as Code (IaC) bezeichnet die Bereitstellung, Konfiguration und Verwaltung von Infrastruktur über maschinenlesbare Dateien, also beispielsweise Code.
Doch Code bleibt Code – unabhängig davon, ob er für Infrastruktur bestimmt ist oder nicht. Die Möglichkeit, Infrastrukturressourcen schnell zu nutzen und zu skalieren, bedeutet auch, dass ihr bei Fehlkonfigurationen Sicherheitsprobleme schneller und in größerem Umfang verursachen könnt.
Laut einem Gartner-Bericht aus dem Jahr 2019 werden 99 % der Sicherheitsvorfälle in der Cloud auf Fehler der Nutzer zurückzuführen sein. Werden Cloud-Ressourcen durch IaC fehlerhaft konfiguriert, bleiben sie meist auch so konfiguriert. Wäre die Fehlkonfiguration im Code offensichtlich, läge sie nicht vor. Und wenn sie manuell entdeckt und behoben wird, tritt sie häufig erneut auf.
IaC-Fehlkonfigurationen und Sicherheitsprobleme zu erkennen, ist daher unerlässlich und sollte ein fester Bestandteil eures Prozesses zur Schwachstellensuche sein.
Einige Erfahrungen teilen
Basierend auf meinen Erfahrungen bei der Implementierung von Schwachstellenscans in Pipelines empfehle ich euch, die folgenden Faktoren zu berücksichtigen, wenn ihr mit DevSecOps in euren CI/CD-Pipelines startet.
Kompatibilität und Benutzerfreundlichkeit berücksichtigen
Findet eine Technologie oder ein Tool, das möglichst viele Bereiche abdeckt. Wenn euer aktueller Stack nur aus node.js und .Net besteht, heißt das nicht, dass er immer so begrenzt oder unverändert bleibt. Mit `npm audit` oder `yarn audit` könnt ihr beispielsweise schnell starten, doch langfristig werden diese Tools vermutlich nicht ausreichen.
Natürlich solltet ihr auch berücksichtigen, wie gut sich eine Technologie oder ein Tool in euren CI/CD-Ansatz integrieren lässt. Darauf liegt schließlich der Schwerpunkt. Stellt euch zum Beispiel folgende Fragen:
Liefert es sinnvolle Exit-Codes, die sich gut für die Automatisierung eignen?
Wie gut lässt es sich in die vielen heute verfügbaren CI-Server integrieren?
Muss ich Workarounds oder Wrapper implementieren, damit es für meinen Pipeline-Flow gut funktioniert?
Ihr versteht, worum es geht. Eine möglichst breite Unterstützung von Programmiersprachen und CI-Servern sowie eine einfache Bedienung sind die wichtigsten Kriterien.
Regeln zur Konfigurierbarkeit
Meiner Erfahrung nach werdet ihr sehr wahrscheinlich auf False Positives stoßen. Nicht alle Sicherheitsprobleme sind für jede Codebase gleichermaßen kritisch, und es wird zwangsläufig Ergebnisse geben, die nicht relevant sind.
Daher ist es wichtig, per Konfiguration festlegen zu können, was für eine bestimmte Codebase gilt – idealerweise so, dass dies zusammen mit der Codebase nachverfolgt und geprüft werden kann. Zum Beispiel über eine Konfigurationsdatei oder Annotationen in der Codebase.
Die Anzahl der Probleme kann besonders bei Legacy-Anwendungen erheblich sein. Häufig ist ein schrittweises Vorgehen nötig, um sie zu beheben. In solchen Fällen müsst ihr Schwellenwerte festlegen können, bei deren Überschreitung die Pipeline fehlschlägt.
Ihr solltet einen Schweregrad konfigurieren können, bei dessen kritischen Ergebnissen die Pipeline fehlschlägt.
Ihr solltet einen Schwellenwert basierend auf einem Schweregrad konfigurieren können, bei dessen Überschreitung eure Pipeline fehlschlägt. Beispiel: Es liegen aktuell drei (3) Findings mit hohem Schweregrad vor. Lasst die Pipeline fehlschlagen, wenn die Anzahl der Findings mit hohem Schweregrad diesen Schwellenwert von drei (3) überschreitet.
Reporting ist entscheidend
Da die meisten Entwickler und DevOps-Praktiker keine Sicherheitsexperten sind, sollten die Ausgaben und Reports der gewählten Technologie oder des gewählten Tools darauf ausgerichtet sein, ihnen die Findings verständlich zu machen: wie sie entstehen und was konkret dagegen zu tun ist. Berücksichtigt dabei Folgendes:
Ein Report sollte umfassende Hinweise dazu geben, wie und wo Findings entstehen. Zum Beispiel die konkrete Datei und Zeile sowie die gesamte Abhängigkeitskette, wenn ein Finding durch die Verwendung eines bestimmten Moduls und einer bestimmten Version entstanden ist.
Ein Report sollte eine klare, prägnante und verständliche Beschreibung des Findings enthalten.
Ein Report sollte ausgezeichnete Hinweise darauf geben, wie Findings behoben werden können. Zum Beispiel: Abhängigkeit Y von Version 3 auf Version 4 aktualisieren.
Ein Report sollte nur relevante Findings enthalten. Findings, die ihr als für die Codebasis irrelevant konfiguriert habt, sollten nicht gemeldet werden.
Die Technologie bzw. das Tool sollte den Report erstellen. Ihr solltet dafür kein weiteres Tool benötigen. Es wird euren Anforderungen wahrscheinlich nicht gerecht werden.
OWASP ist euer Freund
Das Open Web Application Security Project (OWASP) ist eine gemeinnützige Stiftung, die daran arbeitet, die Sicherheit von Software zu verbessern. Das Ziel von OWASP lautet: „Organisationen dabei unterstützen, vertrauenswürdige Anwendungen zu konzipieren, entwickeln, beschaffen, betreiben und warten.“
OWASP bietet neben Projekten und Tools eine Fülle wertvoller Informationen, die euch beim Erreichen eurer Sicherheitsziele unterstützen. Wenn ihr auf Open-Source-Software beschränkt seid, empfehle ich euch, euch die relevanten Projekte anzusehen.
Wenn ihr Webanwendungen entwickelt, solltet ihr unbedingt die OWASP Top Ten kennen. Dabei handelt es sich im Wesentlichen um eine Zusammenstellung der zehn häufigsten und kritischsten Sicherheitsrisiken für Webanwendungen. Ich würde sogar so weit gehen zu sagen, dass jede von euch eingesetzte Technologie bzw. jedes Tool die OWASP Top Ten unterstützen sollte.
Ihr müsst Schwachstellen beheben
Schwachstellen in eurer Pipeline zu identifizieren, ist ein guter Start für eure DevSecOps-Reise. Aber damit seid ihr noch nicht fertig. Ihr müsst etwas dagegen unternehmen.
Definiert eine Strategie zur Behebung der Schwachstellen:
Definiert Prioritäten für die Behebung. Zum Beispiel müssen kritische Findings des Typs X sofort behoben werden.
Definiert den Prozess, um eine Schwachstelle als irrelevant einzustufen.
Berücksichtigt Schwachstellen als Kriterien bei Code Reviews und stellt sicher, dass sie während des Review-Prozesses sichtbar sind.
Und vieles mehr, je nach eurem Anwendungsfall …
Zusammenfassung
Ein rein auf Open-Source-Tools und -Technologien basierender Ansatz wird wahrscheinlich fragmentiert sein. Diese Tools und Technologien bieten zwar definitiv Mehrwert, haben aber jeweils ihre Eigenheiten. Zudem ist nicht immer leicht zu erkennen, was sie abdecken und wie gut sie das tun. Sie haben außerdem unterschiedliche Ausgabeformate, wodurch ihr keinen Gesamtüberblick über euren Sicherheitsstatus erhaltet.
Schwachstellenscans in euren Pipelines zu implementieren, ist ein guter Start, reicht allein aber keineswegs aus. Ihr solltet sie nutzen, um zu verhindern, dass neue Schwachstellen in euren Code gelangen. Allerdings findet ihr Schwachstellen nur während der Ausführung der Pipeline. Zwischen den Ausführungen können neue Schwachstellen entdeckt werden, sodass eure Software für eine gewisse Zeit anfällig bleibt. Das gilt besonders für stabile Codebasen, die sich selten ändern.
Ich würde empfehlen, euch einige kostenpflichtige Technologien bzw. Plattformen anzusehen, statt einen rein auf Open Source basierenden Ansatz zu verfolgen. Mir gefällt Snyk, da es sich gut in den CI/CD-Ansatz und viele CI-Server integriert und damit meine wichtigsten Fokusbereiche abdeckt. Es bietet außerdem ausgezeichnete Reports mit hilfreichen Hinweisen und ermöglicht es euch, eure Codebasis zu überwachen, um zwischen den Pipeline-Ausführungen neue Schwachstellen zu finden. Besonders gut gefällt mir auch, wie Snyk die Findings in einem einzigen Dashboard zusammenführt und so ein besseres Verständnis eures gesamten Sicherheitsstatus ermöglicht.
- DevOps
- CI/CD
- Security
Subscribe to our newsletter
Related blogs


