
Einer unserer Kunden wollte meine Einschätzung zu Apache DevLake (Incubating) wissen. Er erwog, es in seinen Eficode ROOT-Stack aufzunehmen.

Kalle Sirkesalo
Field CTO
Kalle agiert an der Schnittstelle zwischen Unternehmensstrategie und technischer Realität. Er arbeitet direkt mit CTOs und Engineering-Leadern zusammen, um geschäftlichen Druck – Tempo, Compliance, ROI – in tragfähige technische Entscheidungen zu übersetzen. Seine Aufgabe ist es sicherzustellen, dass unsere Empfehlungen für Ihre Organisation auch tatsächlich umsetzbar sind.
Es ist ein neues, spannendes Tool, auf das sich 2023 viele Menschen freuen. Ich habe mich entschieden, eine kurze Einführung in das Tool mit einigen Vor- und Nachteilen zu schreiben und sie hier im Blog zu teilen, um die Neugier vieler Menschen zu stillen. Los geht's.
Vorweg: Apache DevLake ist noch nicht produktionsreif. Das Projekt befindet sich in Bezug auf Datenpipelines eindeutig noch in einem frühen Entwicklungsstadium. Die Unterstützung für Tools ist jedoch bereits hervorragend, und nach allem, was ich gesehen habe, wird es in Zukunft ein fantastisches Tool sein.
Zunächst:
Was ist Apache DevLake (Incubating)?
Im Grunde ist es:
eine Sammlung von Data Collectors
Tools zur Transformation der Daten
Datenmodellierung für DevOps-Metriken
Die Analysen stammen derzeit aus Grafana. Apache DevLake (Incubating) bietet zwar grundlegende Dashboards, aber ich empfehle aktuell, die Daten aus der Datenbank in eurem bestehenden Analytics-Tool zu verwenden.
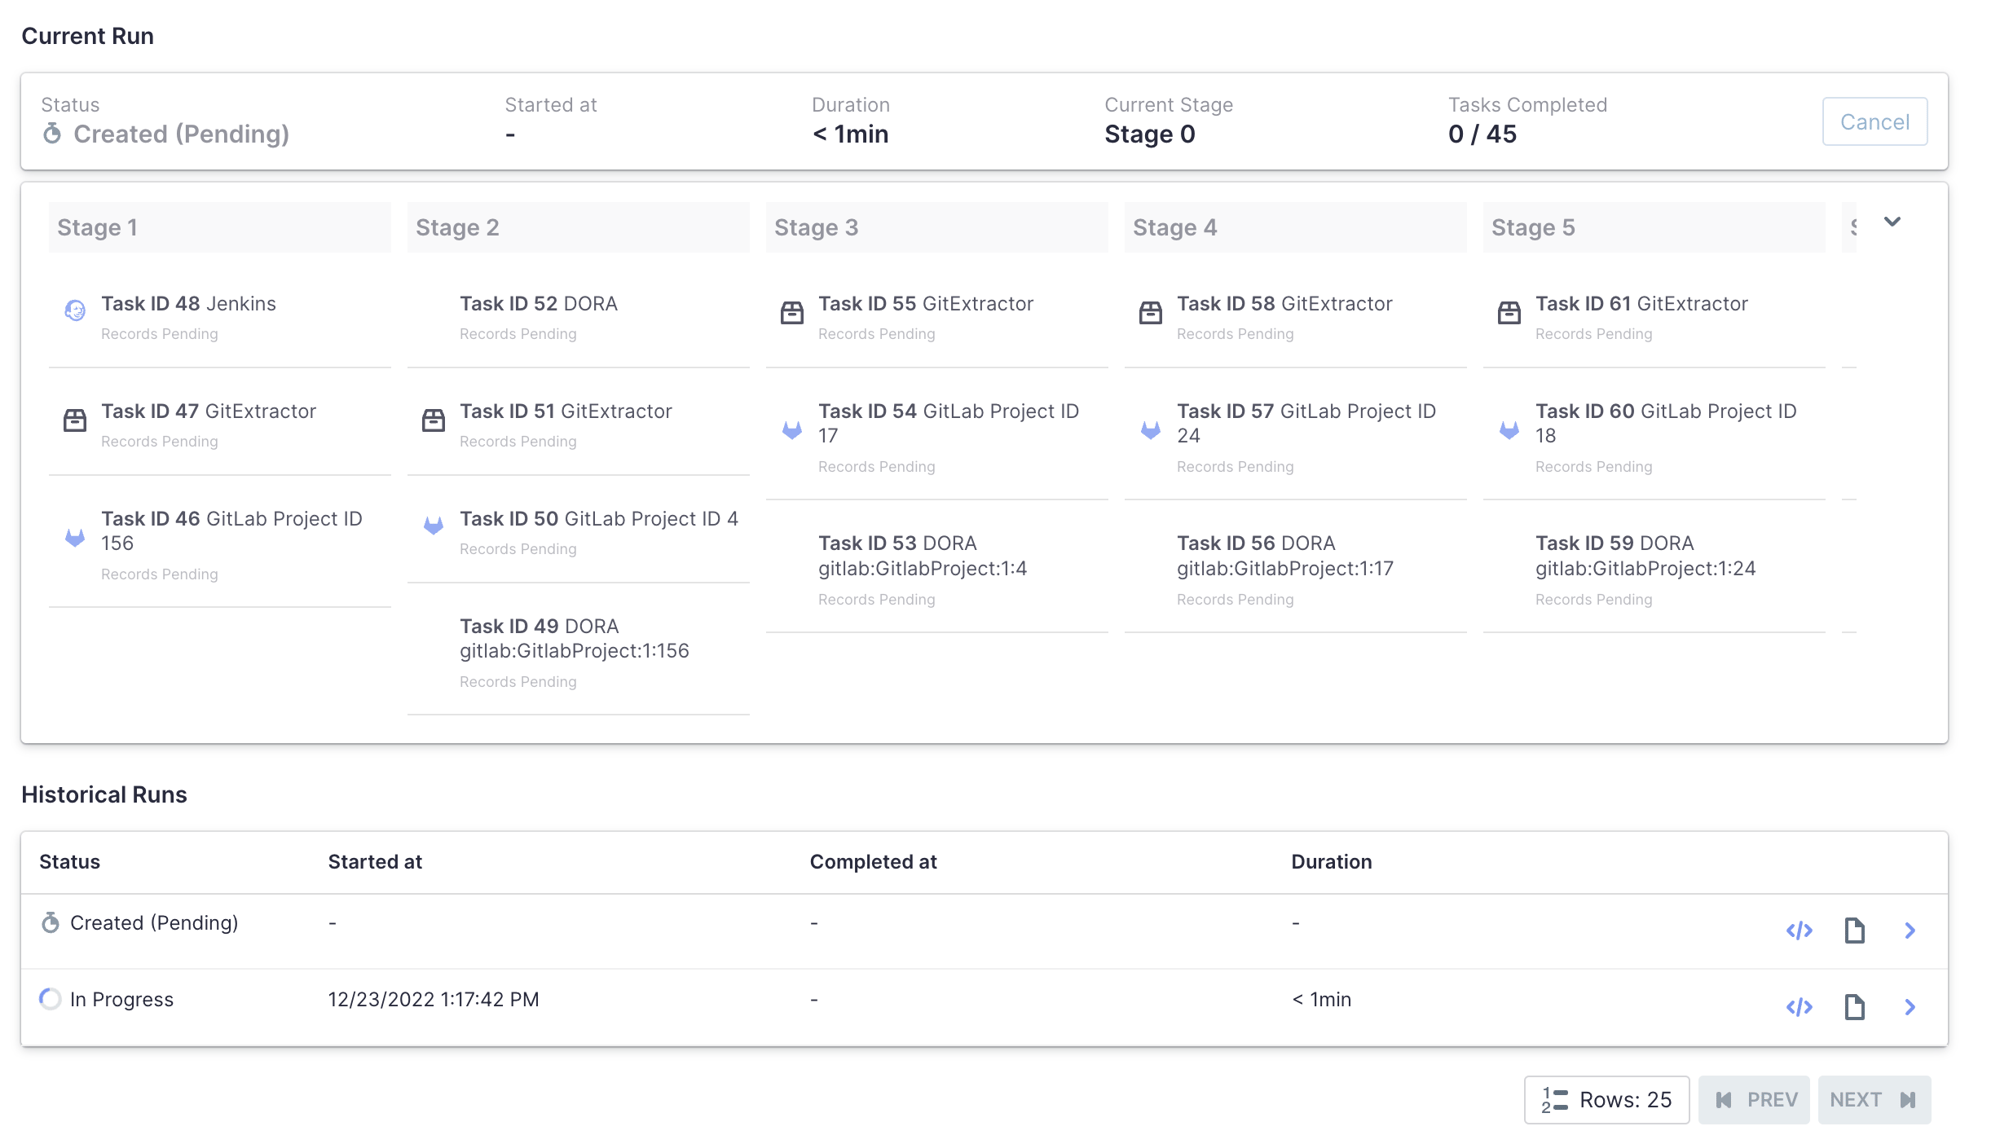
Aktuelle Konfiguration der Apache-DevLake-Collector-Läufe für diesen Blogbeitrag
Das Datenmodell ist gut dokumentiert, sodass ihr problemlos mit eigenen Abfragen starten könnt.
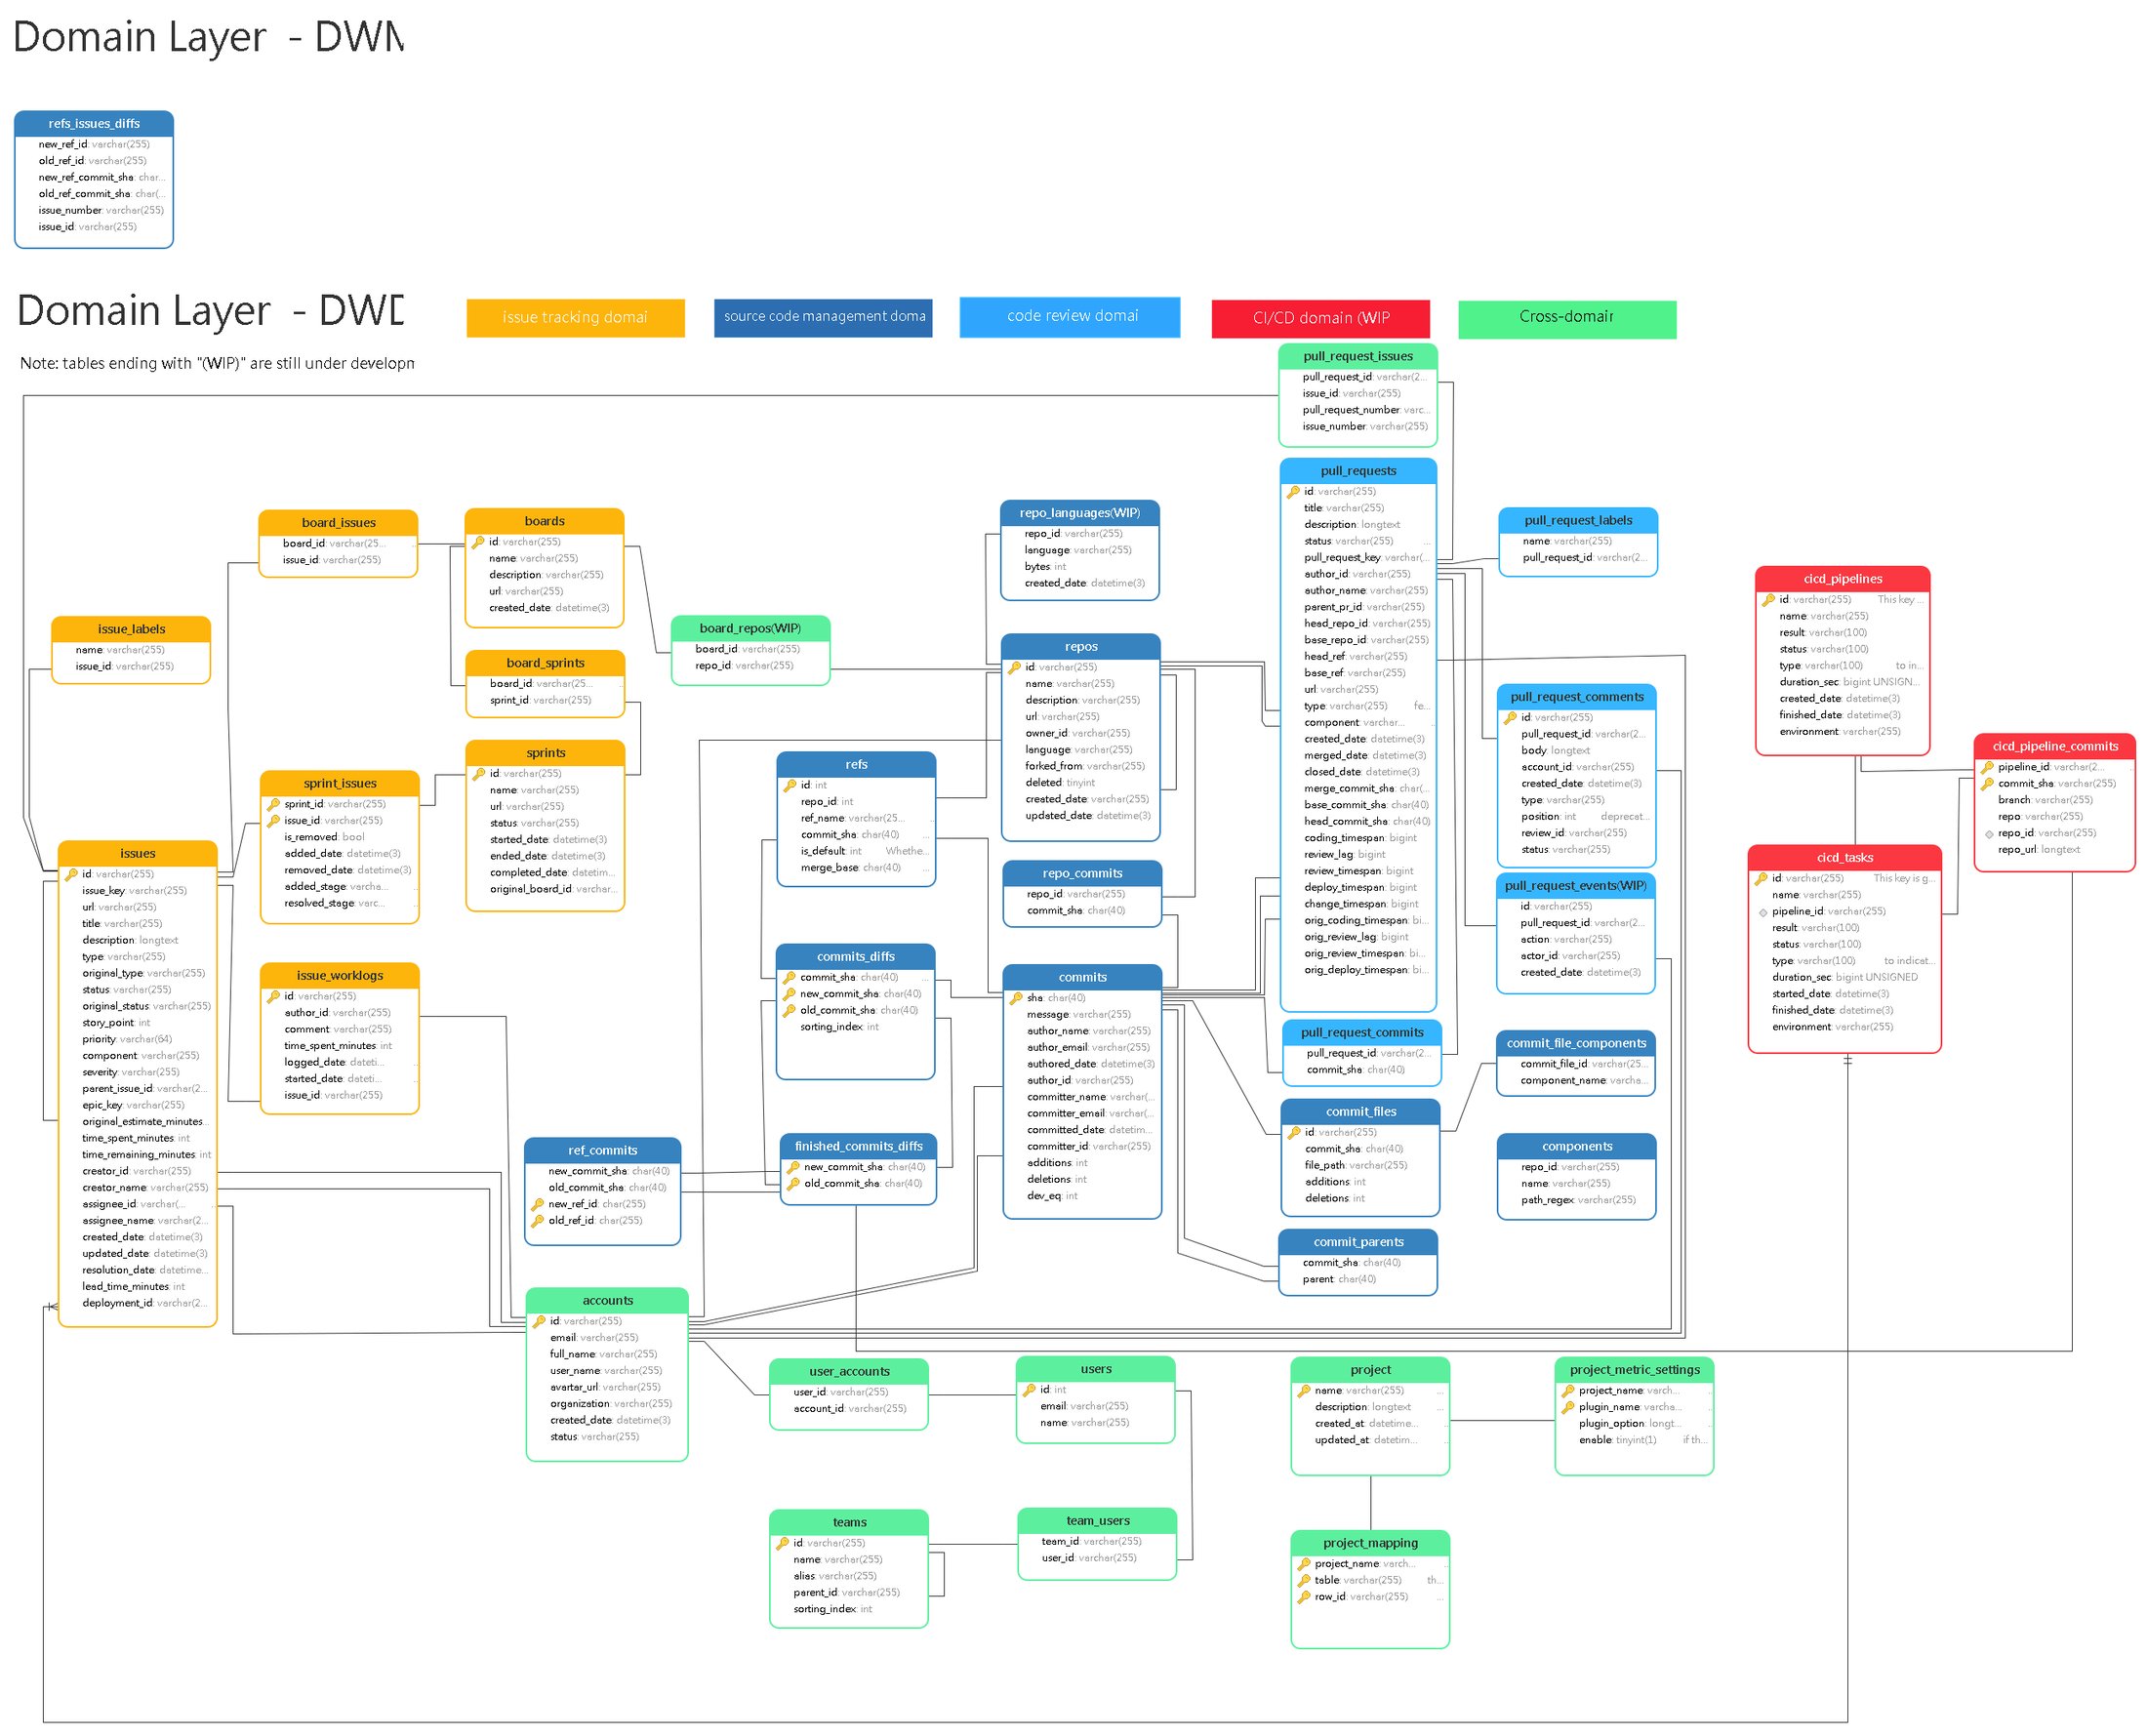
Das aktuelle Datenbankschema Quelle: https://devlake.apache.org/assets/images/schema-diagram-320b5e63de6fabd77794a3043a18fa98.png
Damit sind Analysen der Datenbank – derzeit MySQL – sowohl mit Grafana als auch mit anderen externen Tools möglich. Das größte Problem besteht darin, dass sich dies nicht einfach für mehrere Instanzen nutzen lässt. Wenn ihr statt eines einzelnen Projekts Analysen in großem Umfang durchführen möchtet, erfordert das Abrufen der Daten zudem einiges an Automatisierung.
Apache DevLake (Incubating) ist an sich nichts Neues, da ihr dieselben Integrationen bereits selbst erstellen könnt, beispielsweise direkt von PowerBI zu Jira.
Das Coole an diesem Tool ist, dass ihr Git, CI/CD und Tickets miteinander verknüpft und so Analysen über all diese Daten durchführen könnt. Wenn ihr ein Feature mit einem Commit verbinden könnt, seht ihr klarer, was nötig war, um ein Feature in Produktion zu bringen, oder welche Probleme dieses Feature verursacht haben könnte.
Die Vor- und Nachteile von Apache DataLake (Incubating)
Vorteile:
Es integriert sich mit den wichtigsten Git- und Issue-Trackern: GitHub, GitLab, Bitbucket (bisher über API) und Jira
Analysen basieren standardmäßig auf Grafana – einfach zu nutzen und schnell einsatzbereit
Eine aktive Community entwickelt neue Funktionen
Alles läuft in Containern, sodass der Einstieg leichtfällt
In Go geschrieben, daher sehr effizientes Abrufen von Daten
Konfigurationen können in JSON definiert werden
Hervorragend für Analysen von Teamprojekten
Analytics über REST API machen den Einstieg für jeden besonders einfach
Es gibt eine klare, gut sichtbare Roadmap, auf der ihr seht, woran gearbeitet wird
Nachteile:
Da die Analysen auf Grafana basieren, könnt ihr standardmäßig keine tiefergehenden Analysen durchführen.
Die Konfiguration und das Wissen darüber, wie sich die Datenbank Cloud Native einrichten lässt, fehlen noch.
Bietet euch noch keine Informationen, die ihr nicht auf anderem Weg erhalten könnt.
Ihr müsst Projekte einzeln über die UI oder API-Aufrufe hinzufügen.
Die Felder für den Datenabruf sind noch nicht dokumentiert und unterstützen nicht alle Funktionen der Tools, beispielsweise Jira und Personal Access Tokens.
Für die Definition von Jenkins-Pipelines ist eine Zuordnung zu bestimmten Mustern erforderlich. Das bedeutet, dass Jenkins-Jobs auf eine bestimmte Weise funktionieren müssen.
Ihr könnt keine Ebenen oberhalb der Projekte definieren, also beispielsweise keine Definitionen mit Blueprint erstellen.
Die Berechtigungsstufen für Personal Access Tokens sind nicht dokumentiert und dies ist nicht die Standardmethode.
Es gibt noch keine Unterstützung für Sonarqube.
OpsGenie wird nicht kommen, Pagerduty hingegen schon (ich kann es selbst nicht nutzen, da wir bei Eficode OpsGenie verwenden).
Für Collectors fehlt weiterhin die Authentifizierung (oder zumindest konnte ich keine Konfiguration dafür finden).
Viele Funktionen werden im Hintergrund erstellt. Deshalb müsst ihr viel API-Dokumentation lesen. Das ist auch ein Vorteil, denn sie implementieren aktiv Funktionen, die ihr testen könnt, bevor sie zu tatsächlichen Releases werden.
Beispiel für Git-Analysen aus Grafana
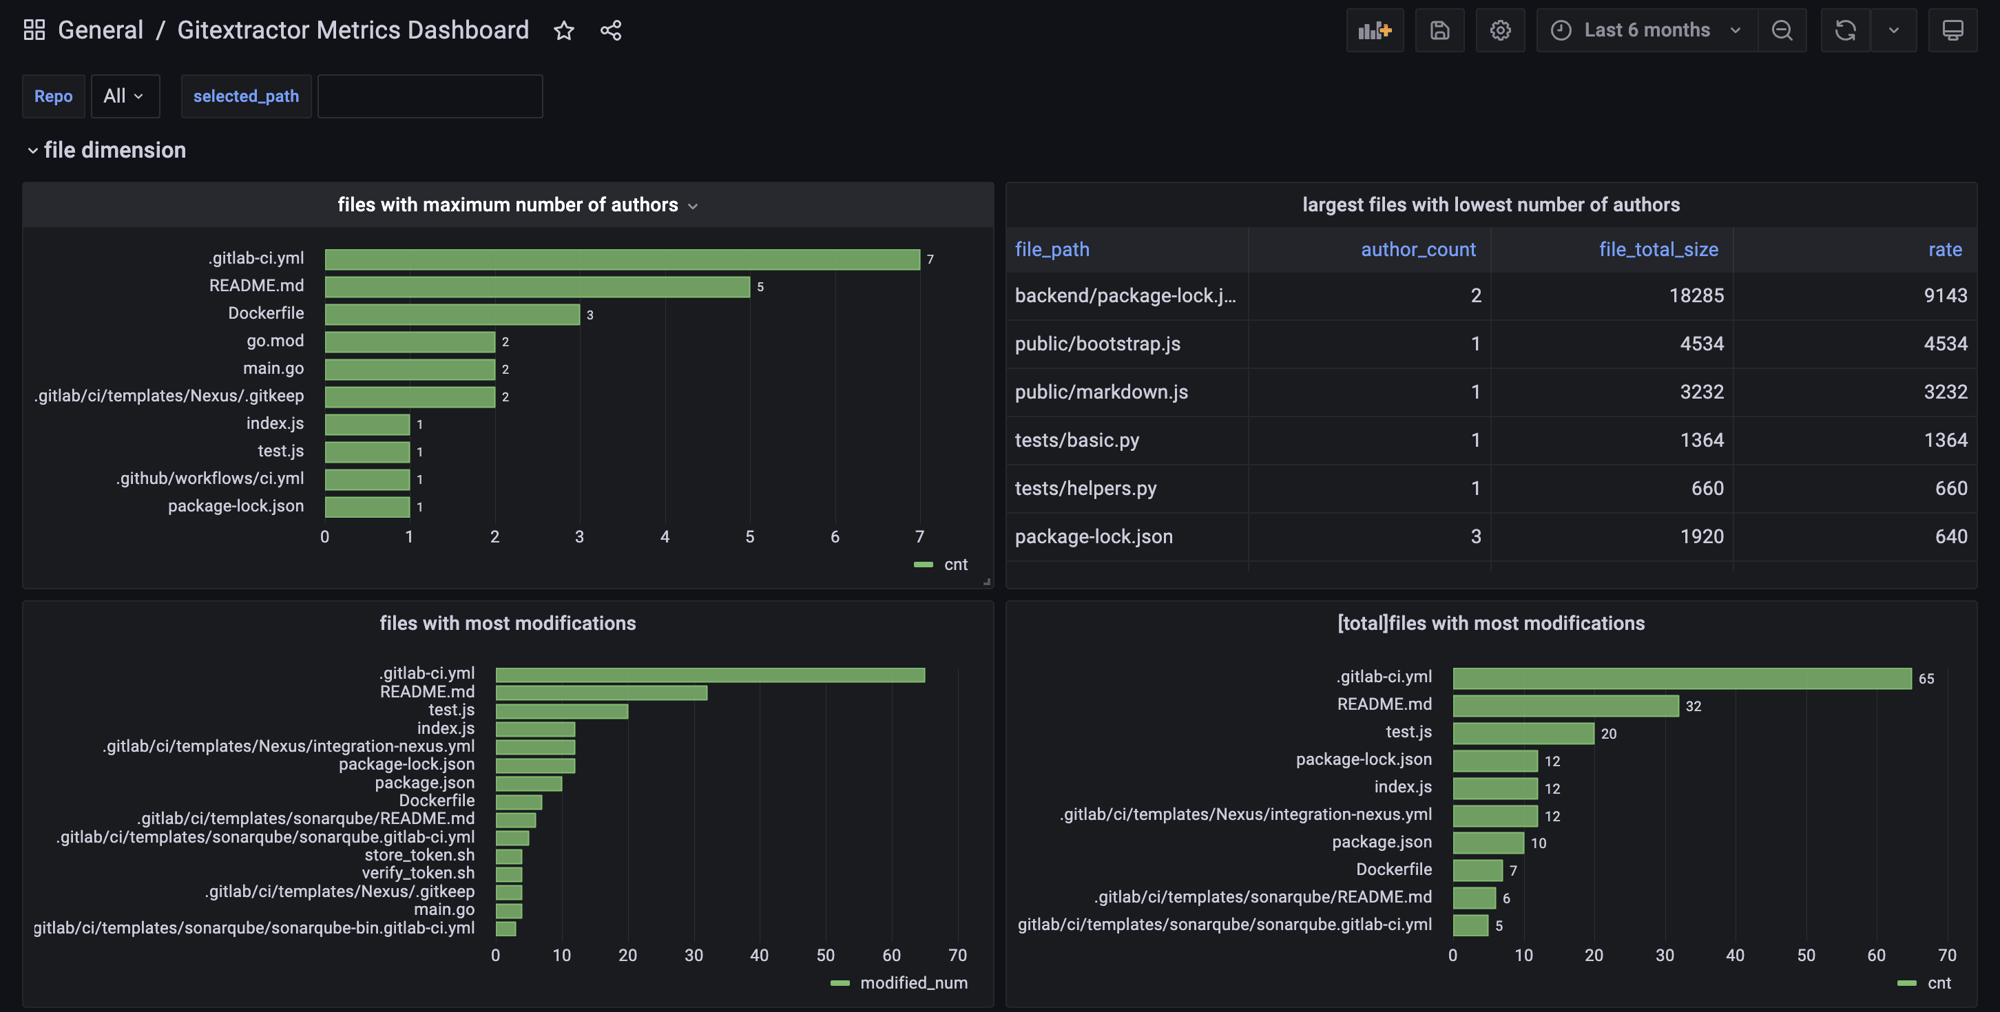
Zusammenfassung
Das waren meine bisherigen Erfahrungen mit Apache DevLake (Incubating). Ich werde dieses Projekt auf jeden Fall weiterverfolgen. Außerdem prüfen wir, ob wir es künftig gemeinsam mit unseren Managed-Services-Kunden in der Beta nutzen können.
Es ist noch nicht ganz bereit dafür, dass wir es unseren Kunden als Service anbieten können. Aber es ist ein äußerst interessantes Projekt, und wir sind gespannt, was das Team damit erreichen wird.
Auch wenn es vielleicht noch nicht für den großflächigen Einsatz in der Produktion bereit ist, könnt ihr es auf Teamebene testen, um zu sehen, wie sich eure Metriken entwickeln. Versprecht nur keine Verfügbarkeit und keine unveränderten Daten.
- DevOps
- Eficode ROOT
- CI/CD
Subscribe to our newsletter
Related blogs


