
En av våra kunder ville höra vad jag tycker om Apache DevLake (Incubating). De övervägde att lägga till det i sin Eficode ROOT-stack.

Kalle Sirkesalo
Field CTO
Kalle sits at the intersection of executive strategy and engineering reality. He works directly with CTOs and engineering leaders to translate business pressures — speed, compliance, ROI — into technical decisions that actually hold. His job is to make sure what we recommend is something your organization can actually execute.
Det är ett nytt och spännande verktyg som många ser fram emot under 2023. Jag bestämde mig för att skriva en kort introduktion till verktyget, med några för- och nackdelar, och dela den här på bloggen för att stilla mångas nyfikenhet. Så nu kör vi.
Låt mig börja med att säga att Apache DevLake inte är redo för produktion. Projektet befinner sig tydligt i ett tidigt utvecklingsskede när det gäller datapipelines. Men stödet för verktyg är redan mycket bra, och utifrån vad jag har sett kommer det att bli ett fantastiskt verktyg i framtiden.
Först och främst:
Vad är Apache DevLake (Incubating)?
I grund och botten är det:
en samling av insamlare för data
verktyg för datatransformation
datamodellering för DevOps-mått
Analysen kommer för närvarande från Grafana. Apache DevLake (Incubating) innehåller grundläggande dashboards, men jag rekommenderar att du tills vidare använder data från databasen i ditt befintliga analysverktyg.
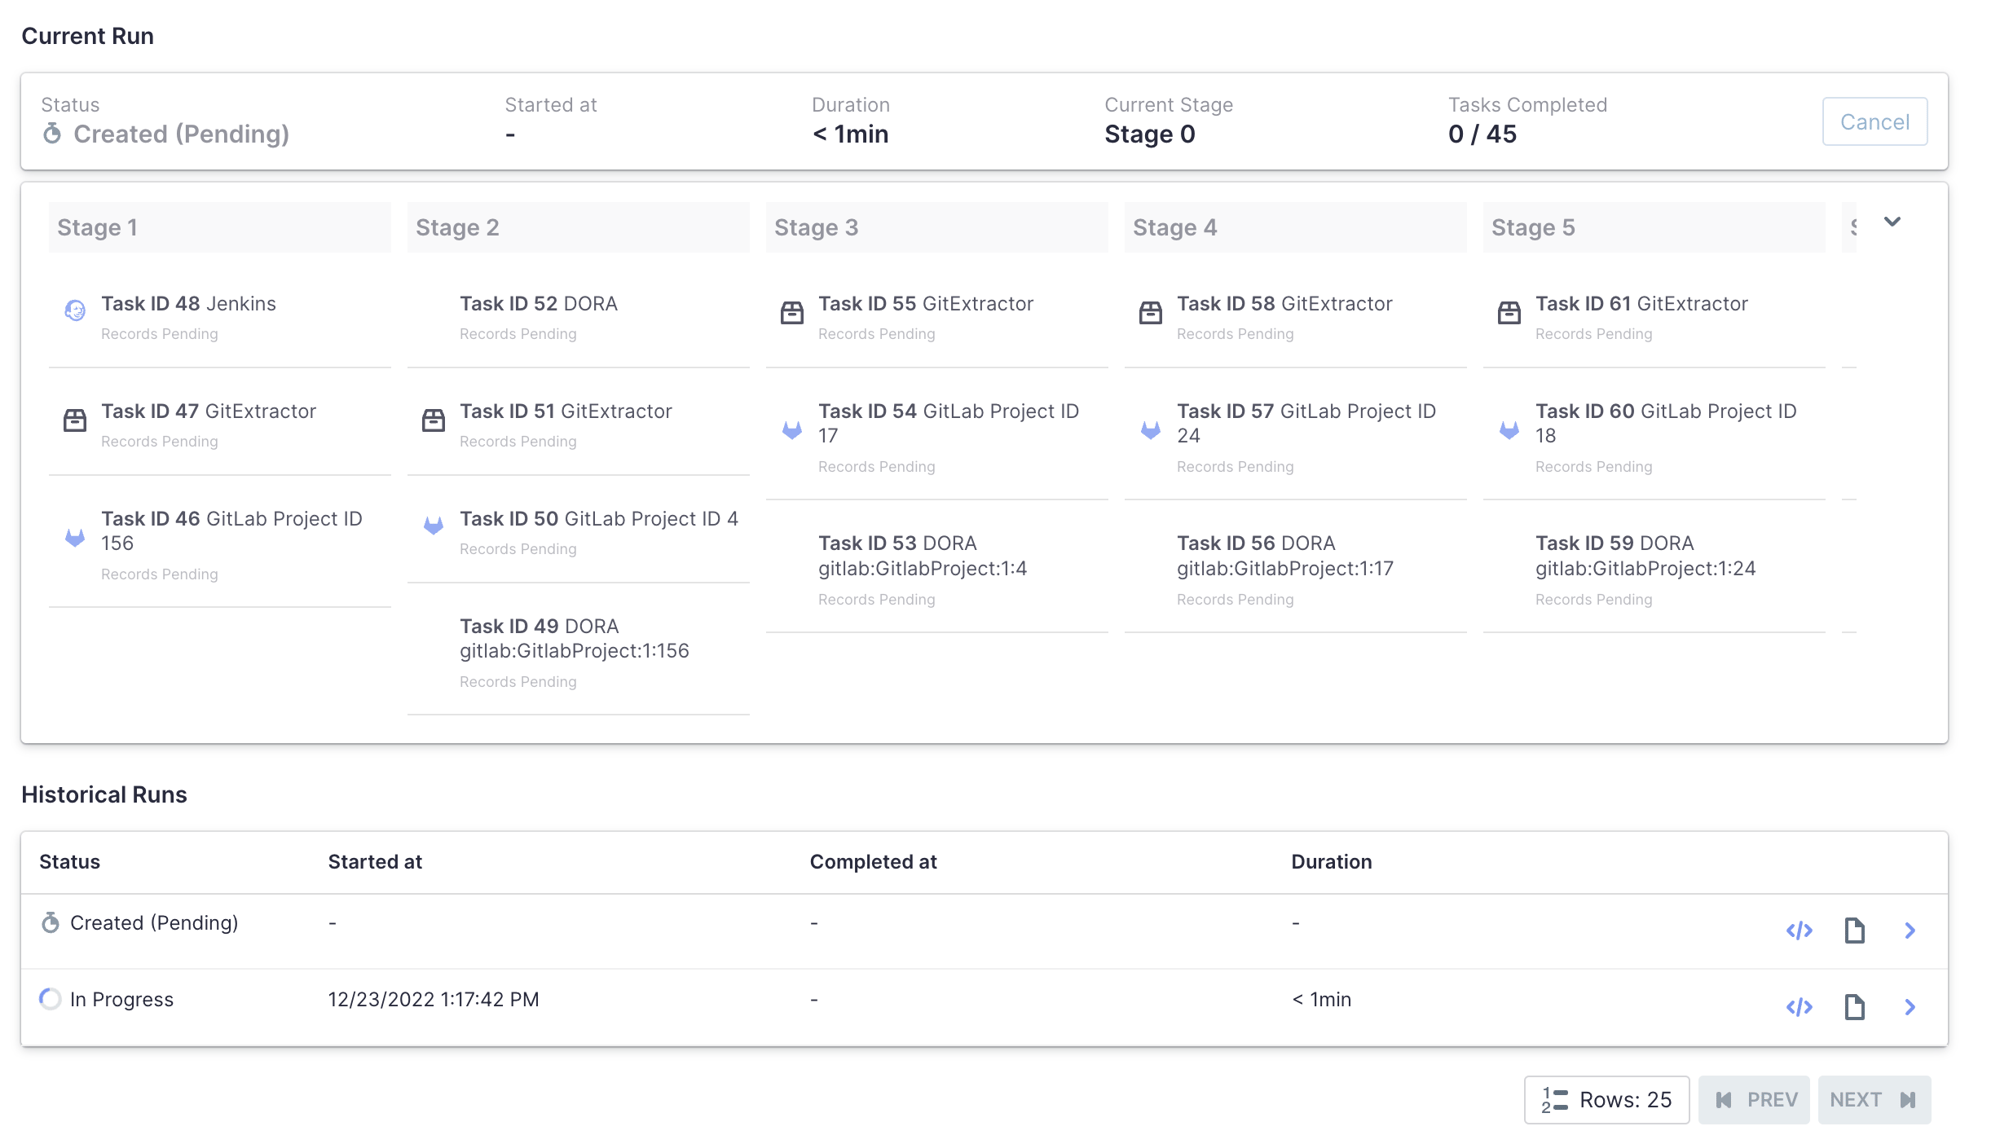
Nuvarande konfiguration av Apache DevLake-insamlingar för det här blogginlägget
Datamodellen är väl dokumenterad, så du kan enkelt komma igång med att skriva egna frågor.
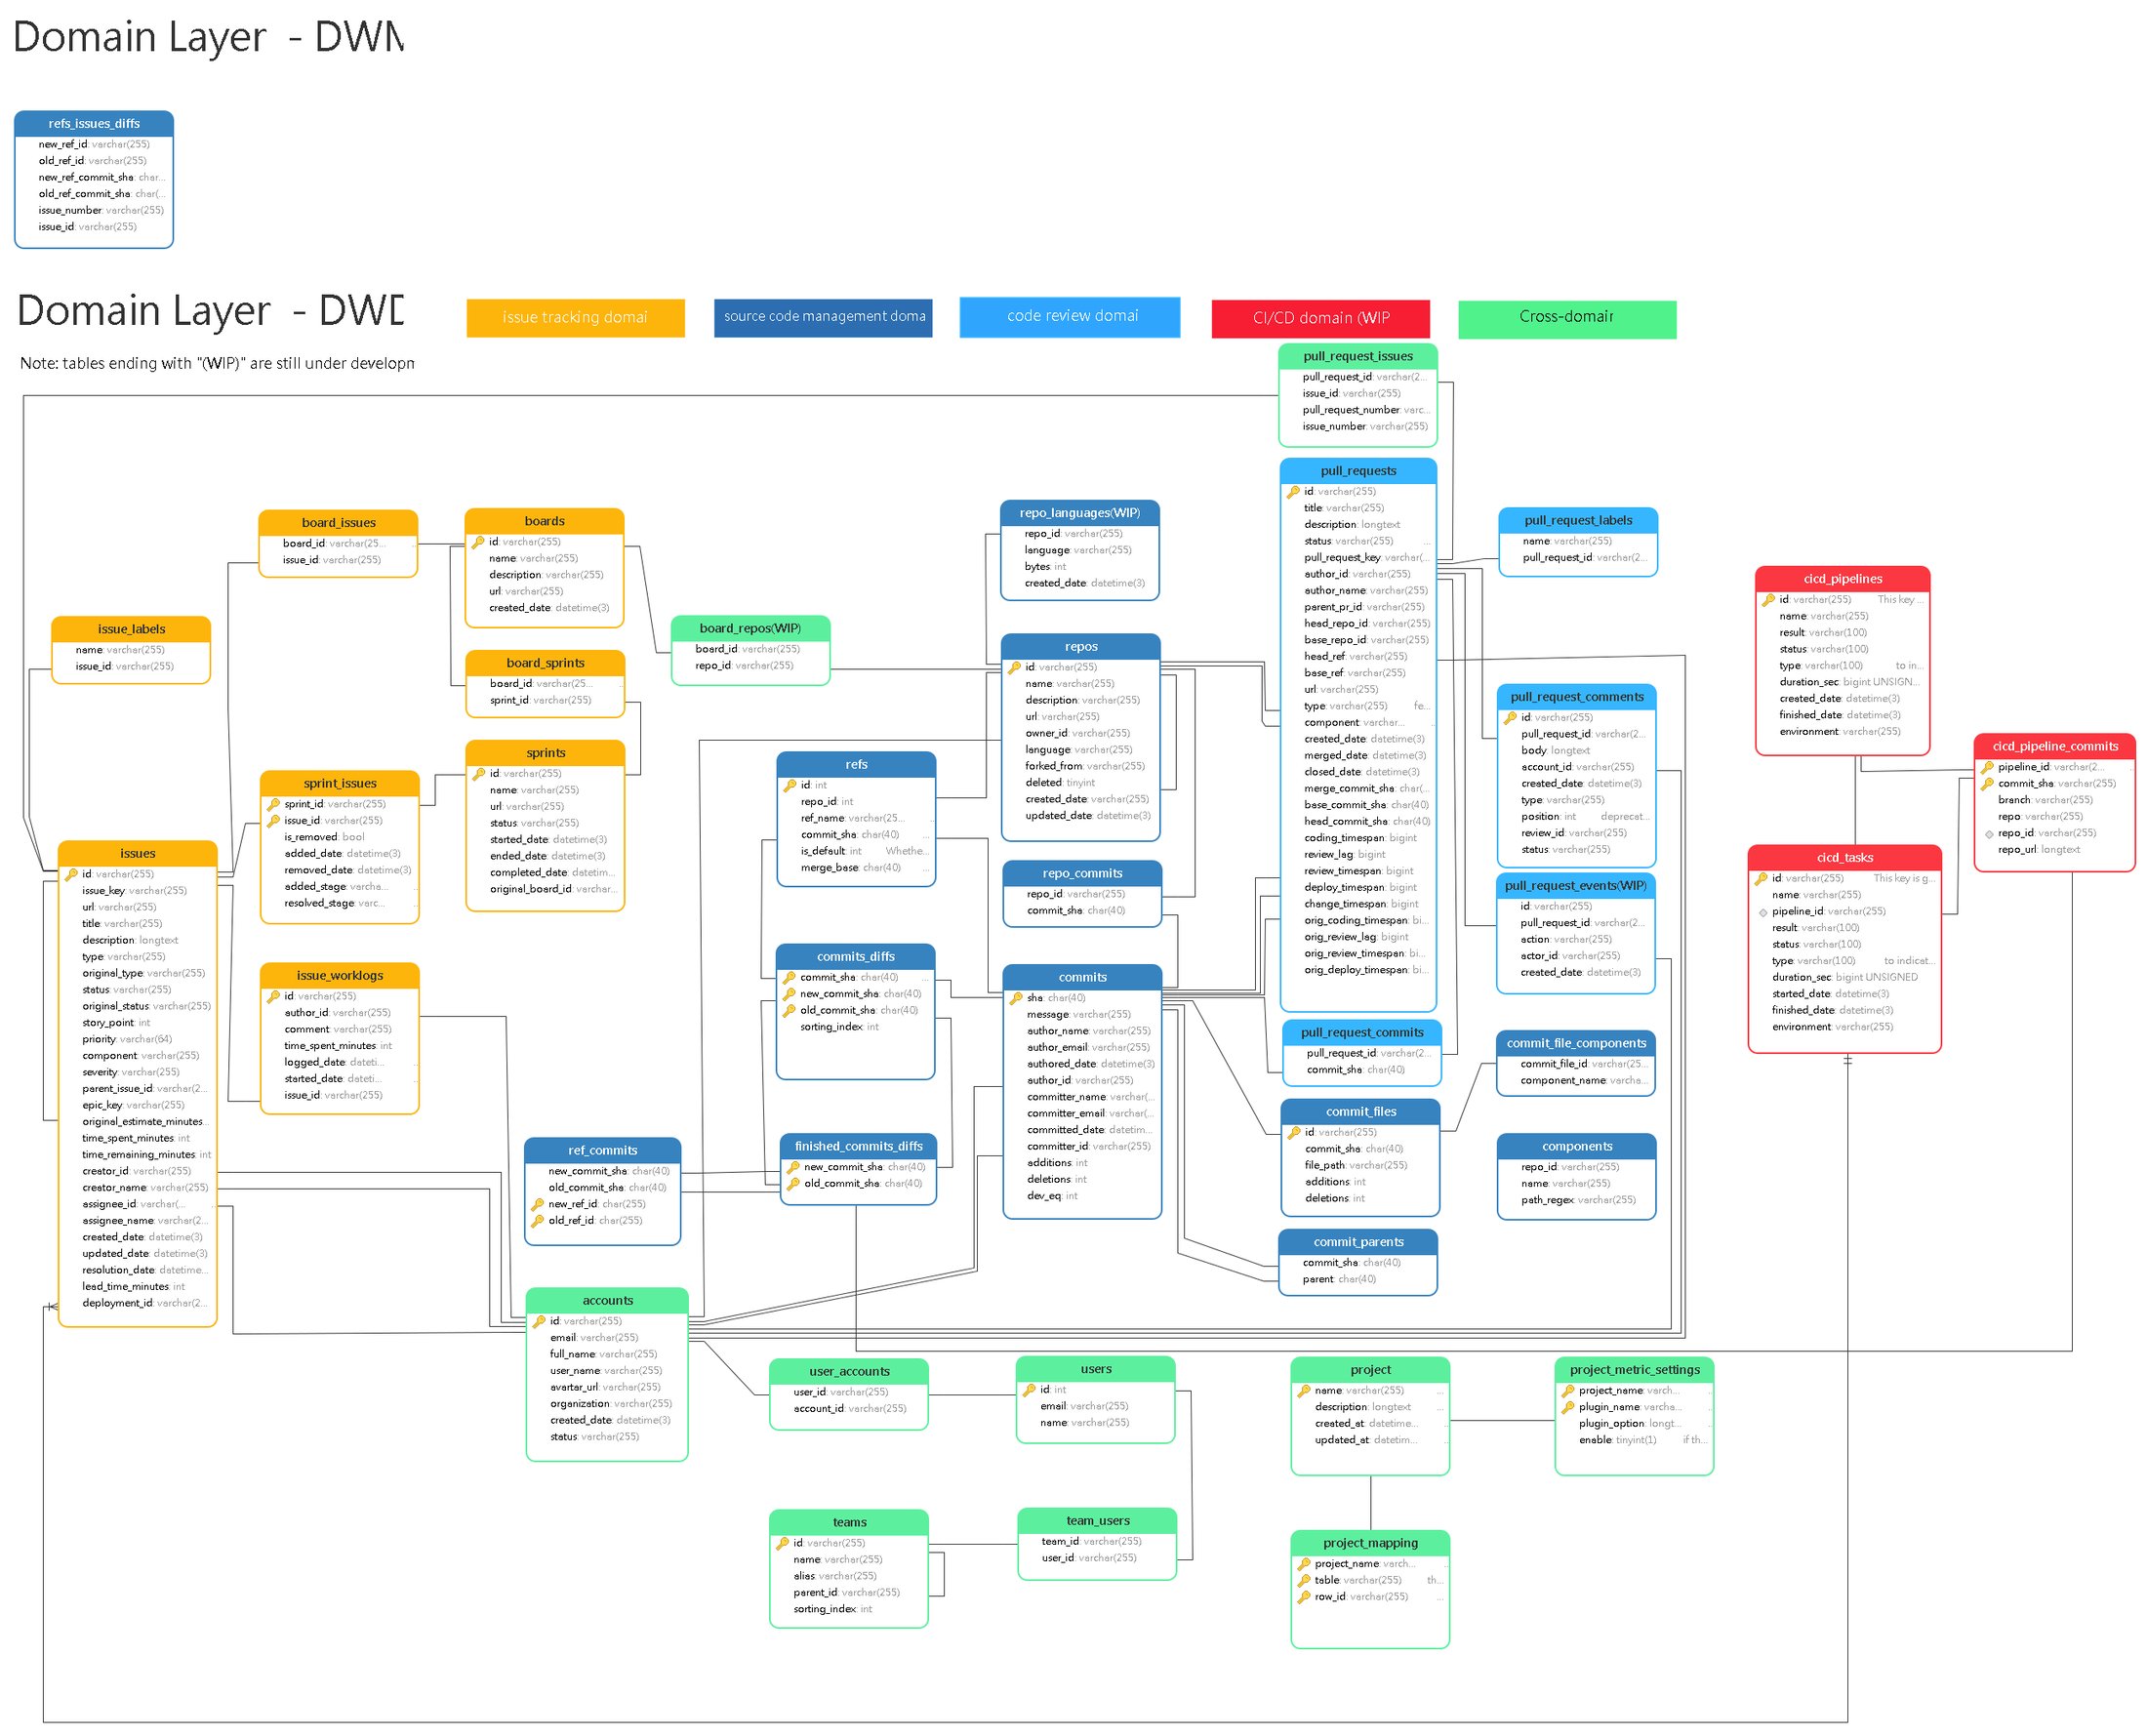
Det aktuella databasschemat Källa: https://devlake.apache.org/assets/images/schema-diagram-320b5e63de6fabd77794a3043a18fa98.png
Detta möjliggör analys från databasen, som för närvarande är MySQL, med både Grafana och andra externa verktyg. Det största problemet är att du inte enkelt kan använda detta för flera instanser, och att hämta data kräver en hel del automatisering om du vill göra analyser i stor skala i stället för för ett enskilt projekt.
Apache DevLake (Incubating) är i sig inget nytt, eftersom du redan kan bygga samma integrationer själv, till exempel direkt mellan PowerBI och Jira.
Det som är bra med verktyget är att du kopplar samman Git, CI/CD och ärenden, så att du kan analysera all den datan. När du kan koppla en funktion till en commit ser du tydligare vad som krävdes för att få funktionen till produktion, eller vilka problem funktionen kan ha orsakat.
För- och nackdelar med Apache DataLake (Incubating)
Fördelar:
Det integreras med de främsta Git- och ärendehanteringsverktygen: GitHub, GitLab, Bitbucket (hittills via API) och Jira
Analysen bygger som standard på Grafana – lätt att använda och snabbt att komma igång med
Det finns en aktiv community som utvecklar nya funktioner
Allt är containerbaserat, så det är enkelt att komma igång
Skrivet i Go, vilket ger mycket effektiva datahämtningar
Konfigurationer kan definieras i JSON
Utmärkt för analys av teamprojekt
Analys med REST API gör det mycket enkelt för vem som helst att komma igång
Det finns en tydlig och synlig roadmap där du kan se vad som utvecklas
Nackdelar:
Eftersom analyserna bygger på Grafana kan du inte göra mer djupgående analyser som standard
Det saknas fortfarande stöd för att konfigurera och veta hur man sätter upp databasen på ett Cloud Native-sätt
Ger ännu ingen information som du inte kan få på andra sätt
Du måste lägga till projekt ett i taget via gränssnittet eller API-anrop
Fälten för datahämtning är ännu inte dokumenterade och har inte stöd för alla funktioner i verktygen (till exempel Jira och Personal access tokens)
För att definiera Jenkins-pipelines måste du mappa till vissa mönster, vilket innebär att Jenkins-jobb måste fungera på ett visst sätt
Du kan inte definiera nivåer över projektnivå, så du kan till exempel inte definiera med Blueprint
Behörighetsnivåerna för Personal access tokens är inte dokumenterade, och detta är inte standardmetoden
Det finns ännu inget stöd för SonarQube
OpsGenie kommer inte, men PagerDuty gör det (jag kan inte använda det själv eftersom vi använder OpsGenie på Eficode)
Autentisering saknas fortfarande för collectors (eller så kunde jag åtminstone inte hitta konfigurationen)
Många funktioner skapas i bakgrunden, så du behöver läsa igenom mycket API-dokumentation (detta är också positivt eftersom de aktivt implementerar funktioner som du kan testa innan de blir faktiska releaser)
Exempel på Git-analys från Grafana
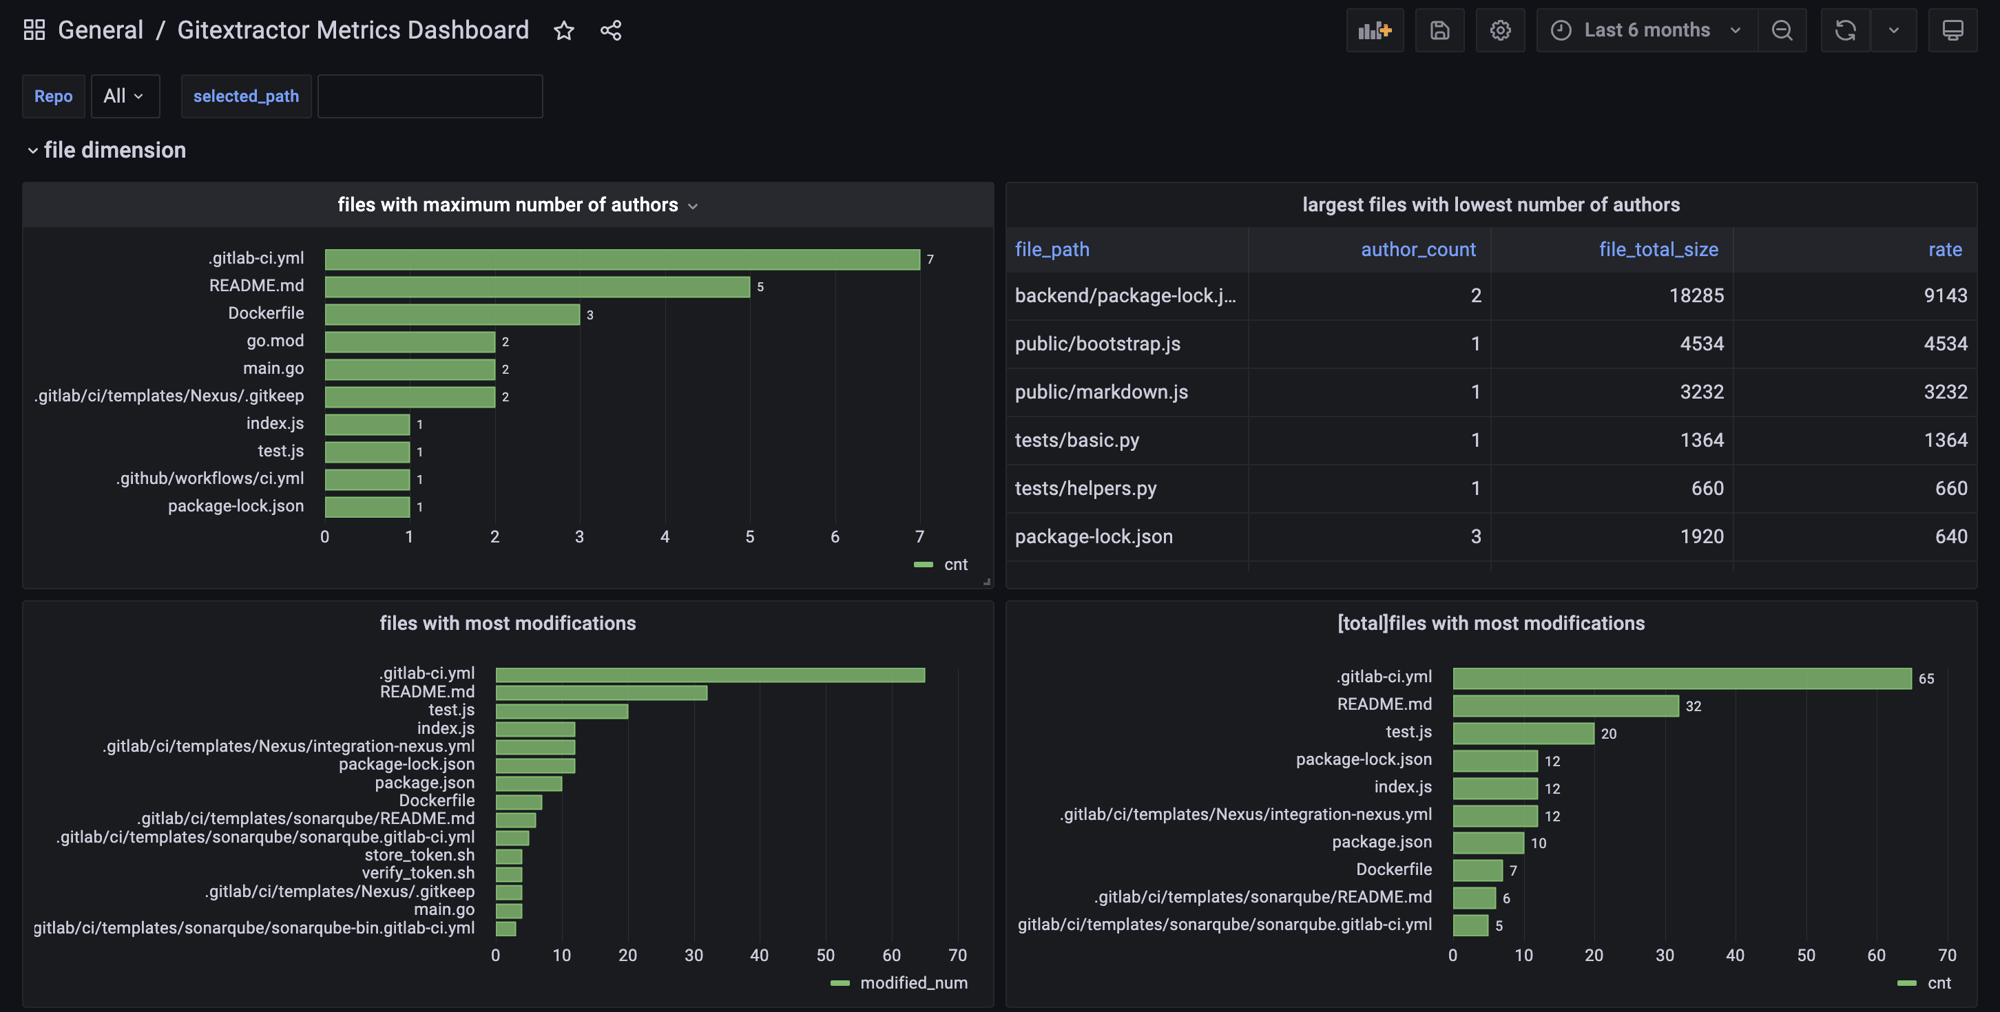
Sammanfattningsvis
Detta var mina nuvarande erfarenheter av Apache DevLake (Incubating). Jag kommer definitivt att följa projektet, och vi undersöker också möjligheten att erbjuda betaanvändning till våra kunder inom managed services framöver.
Det är inte riktigt redo för att vi ska kunna erbjuda det som en tjänst till våra kunder. Men det är ett mycket intressant projekt, och vi ser fram emot att se vad teamet kan göra med det.
Även om det kanske ännu inte är redo för produktionsanvändning i stor skala är det definitivt något du kan testa på teamnivå för att se hur dina mätvärden utvecklas. Lova bara inte någon tillgänglighet eller att datan förblir oförändrad.
- DevOps
- Eficode ROOT
- CI/CD
Subscribe to our newsletter
Related blogs


