
Jira har blivit branschstandard för projektadministration och är betydligt kraftfullare än Redmine när det gäller hur du kan konfigurera arbetsflöden för enskilda projekt. Jira har fullt stöd för Agile-utveckling med Scrum, medan Redmine har begränsat stöd för olika arbetssätt. Så hur går du över till Jira om du i dag använder Redmine?

Mads Jensen
Mads works as a consultant at Eficode in Denmark. He is passionate about automation and testing, and in general to get the most of the tools he uses. He occasionally contributes to open-source projects, in particular to the Django web framework. He likes riding his bike for both sport and transportation and enjoys watching movies.
1. Varför migrera från Redmine till Jira?
Jira har flera fördelar jämfört med Redmine, vilket också framgår av Atlassians egen jämförelse av de två verktygen:
Jira har fullt stöd för Scrum och inkluderar tavlor och statistik för sprintarna. Sprintar kan pågå under valfritt antal veckor, och det är enkelt att se varje teammedlems arbetsbelastning i varje sprint.
Workflows kan enkelt anpassas efter företagets behov, till exempel så att ett ärende måste gå igenom alla olika steg innan det kan stängas. Till skillnad från Redmine går det även att konfigurera ett workflow för ett specifikt projekt i Jira. I Redmine delas workflow och statusar globalt mellan alla projekt.
Workflows har stöd för validerare, villkor och efterfunktioner som kan användas för att automatisera processer. Standardinstallationen av Jira har flera alternativ för villkor som kan tillämpas på ett workflow.
Tavlor som visar ärendenas statusar kan anpassas i stor detalj. I Jira går det att konfigurera frågor som passar för dagliga Scrum-möten, vilket gör det enkelt att se vad varje person arbetade med dagen innan. I Redmine behöver dessa filter ställas in varje dag.
Scheman för fältkonfiguration är ganska flexibla och kan användas för att anpassa vilka fält som är obligatoriska i ett visst projekt och för vissa ärendetyper.
Redmine har inte fullt stöd för Scrum och är mer inriktat på ett Kanban-baserat arbetssätt. Redmine saknar epics, men har stories, buggar och underuppgifter. Jira inkluderar epics, stories, underuppgifter och buggar.
Dessutom har Jira två tavltyper: en för Scrum och en för Kanban. Båda tavlorna kan konfigureras med frågor för att undvika att upprepa vanliga sökningar.
Redmine har ett par fördelar
Redmine erbjuder en tidrapporteringsmodul med mer detaljerad information än vad Jira erbjuder som standard. I Redmine finns ett extra aktivitetsfält utöver fälten för nedlagd tid och kommentarer i Jira.
Redmine är dessutom programvara med öppen källkod och kräver därför inga licenser. Det kan vara ett skäl att fortsätta använda Redmine, eftersom projektet fortfarande underhålls aktivt.
2. Exportera och konvertera data.
För att gå från Redmine till Jira behöver allt pågående arbete migreras från det ena systemet till det andra. Migreringen omfattar följande steg:
Exportera data
Konvertera data
Importera data
Anpassa presentationen i Jira
Det finns ett par sätt att genomföra migreringen, men oavsett vilken metod som väljs bör steget för presentationen vara ungefär detsamma.
Före Jira 8.4
Till och med Jira 8.3 erbjuder Atlassian import från olika tredjepartsverktyg som Redmine, Trac och Trello. Dessa verktyg ingår i standardinstallationen av Jira. Alternativet hanterar i huvudsak de tre första migreringsstegen som nämns ovan.

När du har angett inloggningsuppgifterna får du välja vilka projekt som ska importeras och till vilka Jira-projekt, hur anpassade fält ska mappas och hur länkar ska skapas.

Tyvärr upphörde Atlassian med stödet för automatiska importplugin från och med Jira 8.4, vilket innebär att import endast kan göras med CSV eller JSON.
Vi valde att använda de automatiserade verktygen. Importverktyget hanterar sådant som skulle kräva fler överväganden vid JSON-import, men är samtidigt mindre flexibelt.
När du skapar ett projekt i Jira måste du välja en projektmall som beskriver workflow och tillgängliga statusar. För migreringen använde vi en särskild projektmall för att beskriva statusar från Redmine i Jira.
Redmine-projekt hade fler statusar att välja mellan än standardprojektmallarna i Jira erbjöd. Därför behövde vi anpassa Jira så att statusarna från Redmine återspeglades.

I vårt fall behövde vi anpassa en projektmall för att få en korrekt mappning av statusarna. Projektmallarna kan anpassas så att de omfattar statusar som det inte går att övergå till, men som behövs för efterbearbetningen så att teamen själva kan välja vilka statusar ärenden ska flyttas till. Flera statusar i Redmine kan mappas till en status i Jira, men eftersom det skulle innebära att göra antaganden åt andra beslutade vi att vissa statusar skulle finnas kvar tillfälligt. Det finns några gula statusar som används för samma sak. Ärenden med statusen In Test kanske egentligen ska ha statusen In Progress, och i så fall är det enkelt att massflytta dem. Det vore omöjligt om man gjorde antaganden under importen.
Problem med importverktyget
Varje gång du importerar ett nytt projekt skapas ett nytt anpassat fält som mappar det gamla systemet till Jira. Fältet används för att förhindra att samma ärenden importeras igen. Men det innebär också att dessa fält behöver slås ihop ytterligare. ScriptRunner erbjuder en funktion där du, utifrån ett fördefinierat filter, kan slå ihop sådana fält till ett enda anpassat fält. Listan över anpassade fält växer ju fler projekt du importerar, så det är lätt att tappa överblicken. I Jira kan du anpassa hur ärendedata visas, så genom att begränsa detta till ett enda fält blir det också enklare att anpassa vyn. Det gör det även lätt att skicka instruktioner till berörda team om hur de kan söka efter gamla ärenden. Observera att när du lägger till ett fält på en visningsskärm visas namn och värde endast när det finns ett värde.
Upplösningsstatusarna mappades inte korrekt. Vi fick en upplösningsstatus med värdet ”1” i Jira från migreringsverktyget, vilket inte beskriver hur ärendet löstes. Kunden brydde sig inte särskilt mycket om gamla ärenden som redan hade lösts, så upplösningsstatusen togs bort som alternativ från upplösningsskärmen. Det innebar att nya ärenden inte skulle lösas med den meningslösa upplösningsstatusen. I ett workflow finns det vissa egenskaper som kan ställas in för en övergång och som påverkar upplösningsskärmen. I praktiken har projekten fortfarande denna märkliga upplösningsstatus, men nya ärenden kommer inte att kunna ange detta värde som upplösningsstatus.
Ärendenumren, till exempel PROJ-1234, som importverktyget tilldelar är slumpmässiga. Därför återspeglar ökande ärendenummer inte när ett ärende skapades.
Importverktyget importerar inte all relevant data. För Redmine-projekt som hade delprojekt skapade vi en komponent i Jira med samma namn som delprojektet i Redmine. Komponenter i Jira är mer flexibla än delprojekt i Redmine eftersom de kan ha en standardansvarig för ärenden. I vårt fall behövde vi ange värdet för Story points, de fasta versionerna (även kallade release) för ärenden samt komponenten för projekt med delprojekt. Vi itererade helt enkelt över en lista med relevanta parametrar och gjorde sedan REST API-anrop för varje ärende. Netrc-filen innehåller autentiseringsuppgifter för att autentisera användaren mot Jira.
I Jira finns ett antal anpassade fält som kan anges om kontexten har konfigurerats för ett projekt. Det anpassade fältet 10006 är för story points. ID:n för de anpassade fälten finns i Jira-administrationen. Observera att om du planerar att använda andra anpassade fält i Jira för din migrering måste du konfigurera en kontext för fältet för att kunna ange det i ett projekt. Annars misslyckas REST API-anropet med en varning om att fältet inte kan anges för ärendet.
Jira 8.4 och senare
Atlassian meddelade att importpluginen inte längre är tillgängliga från och med Jira 8.4. Det kommer dock fortfarande att vara möjligt att importera JSON- eller CSV-filer. Det innebär naturligtvis mer arbete, eftersom all relevant data måste extraheras via REST API:t i verktyget som du migrerar från. Vissa verktyg kanske inte erbjuder något REST API, eller så exponerar REST-slutpunkterna inte all data du vill hämta. Om du använder Jira 8.4 eller senare och vill migrera från ett gammalt system har Atlassian detaljerad dokumentation om formatet som kan användas för import. CSV är troligen bara ett bra val om datamängden är ganska liten och endast innehåller mycket grundläggande information om ärendena. CSV är betydligt mindre utförligt än JSON eftersom det bara finns en rad per ärende. Med JSON är det enklare att granska och söka i data med exempelvis jq, vilket gör hantering och kontroll betydligt enklare.
Redmine har ett REST API som stöder extrahering av nödvändig data. Det omfattar användare, ärenden med metadata (kommentarer, relationer, releaser) och projekt. Viss data kan inte extraheras med REST API:t, till exempel datum för ett projekts releaser, och måste extraheras manuellt från Redmines gränssnitt.
Vi hade inget färdigt konverteringsskript. Däremot behövde vi skriva Python-kod som genererade JSON för att importera länkar till underärenden korrekt, och att utöka den till att omfatta användare, projekt och ärenden – inklusive bilagor – verkar hanterbart. Vi bortser från copied_to-länkarna eftersom de redan hade hanterats av importpluginet.
Skriptet använder f-strings, som introducerades i Python 3.6. Skriptet kan köras med:python import-links.py <Jira project key>
Anpassa visningen i Jira
Även om vi valde att importera och konvertera data med importpluginen finns det saker att ta hänsyn till efter migreringen. I Jira finns skärmar för olika ärendetyper, antingen för ett enskilt projekt eller delade mellan flera projekt. Det finns tre skärmar för varje ärendetyp:
En visningsskärm
En skärm för att skapa ärenden
En uppdateringsskärm
På visningsskärmen är det bra att inkludera Redmine-ärende-ID:t. På skärmarna för uppdatering och skapande bör det externa ärendet däremot inte visas. Attributen komponent och fixversion är redan konfigurerade som standard för de tre skärmarna.
Det finns inga tavlor i Redmine, så för de olika projekten skapades två tavlor: en Scrum-tavla och en Kanban-tavla. Tavlorna är konfigurerade med kolumner för Ej beslutat (behöver mer information), Att göra, Pågår, Verifiering och Klar. Administratören kan ändra vilka ärenden som visas i de olika kolumnerna. Administratören kan dessutom lägga till snabfilter. Vi skapade några snabbfilter för att inkludera ärenden för olika teammedlemmar och för komponenter, eftersom Jira inte listar komponenterna till vänster i backloggen. Det finns en flik för epics och versioner, så det är enkelt att filtrera på dessa värden och flytta ärenden till en sprint. Komponenter borde ha varit ett alternativ under epics, där markeringen finns.

3. Problem med standardfunktionaliteten? Så här gjorde vi.
Vi migrerade med importplugins, men oavsett metod finns det alltid saker att ta hänsyn till.
Vilken typ av data vill du importera?
REST API erbjuder inte redigering av all data i Jira. Till exempel kan en sprints slutdatum inte anges med REST API, vilket innebär att sprintens statistik går förlorad. Det går däremot att göra med tillägget ScriptRunner. Om du inte har det tillägget i systemet får du klara dig utan det.
Kommentarer kan importeras utan rätt användare
Vid import med pluginverktyget importeras användare från de berörda projekten. Om en användare har skrivit en kommentar mappar Jira den korrekt. Men om en användare inte importeras på grund av något problem – troligen för att användaren har avaktiverats – skapas kommentaren med personen som kör importen i Jira som författare. I de fallen var ScriptRunner användbart för att ta bort och återskapa kommentaren med rätt författare.
Om ScriptRunner inte är tillgängligt kan du köra importen igen efter att ha tagit bort de ärenden där kommentarförfattaren är personen som körde importen. Användaren måste skapas manuellt i Jira med samma användarnamn innan importen körs igen. Kom ihåg att användaren ska vara inaktiv och att du kan använda en ogiltig e-postadress. Importverktyget använder det externa ärende-ID:t för att avgöra vilka ärenden som redan har importerats. Det anpassade fältet kan inte byta namn under migreringen, eftersom ett nytt anpassat fält då skapas och alla ärenden importeras, vilket i praktiken duplicerar all information.
Buggar i importpluginet
I Jira summeras loggat arbete i underärenden till det överordnade ärendet, så att det är enkelt att se hur mycket tid som har lagts ned totalt. Problemet var att importverktyget inte skapade rätt länkar från underärendena, vilket ledde till fel i beräkningarna av nedlagd tid.
För att lösa problemet skrev vi ett litet Python-skript som genererade JSON för att importera länkarna korrekt. Python-skriptet visas ovan. Den här Python-funktionen läser in relationer av alla typer från ett Redmine-ärende, till exempel copied_to, som motsvarar Jiras cloners- eller dubblettrelationer.
Begränsningar i Redmine REST API
Redmine exponerar inte datum eller öppet/stängt-status för en release via REST API. Datumen var endast tillgängliga via webbsidor. Därför skrev vi också ett litet Python-skript för att hämta datumen från HTML-sidorna, så att de kunde anges med REST API.
Importplugins fungerar inte optimalt.
Vi har stött på några problem med importplugins, vilka lyfts fram i texten ovan. För de flesta berörda team var målet att kunna arbeta i Jira, så historiska data kunde presenteras något annorlunda än i verktyget de migrerade från.
Att skriva skript för att extrahera data från Jira 8.4 (och även Jira 7) och senare versioner är en bra investering, eftersom det ger bättre kontroll över hur data importeras. Redmine har inte samma begrepp för skapare och rapportör som Jira. Helst bör alla importerade ärenden ha samma värden för skapare och rapportör. Importverktyget anger dock personen som kör importen som skapare. En fördel med det kan vara att det blir enkelt att identifiera att ärendena kommer från ett tredjepartssystem.
Lösningsdatum för importerade ärenden
ScriptRunner innehåller även vissa funktioner, till exempel en som korrigerar ett ärendes lösningsstatus. Den bevarar dock inte lösningsdatumet och hanterar bara massåtgärder med fler än 1 000 ärenden åt gången. Lösningsdatumet behövs för olika typer av statistik och diagram. Gränsen på 1 000 ärenden tillämpas av Atlassian vid massredigering via gränssnittet. Problemet med lösningsdatum i det inbyggda skriptet kan lösas genom att skriva ett eget skript, och vi har ett i vårt code-utils repository.
Många anpassade fält för externa ärende-ID:n
När många enskilda projekt importeras skapas ett anpassat fält för externa ärende-ID:n för vart och ett av de importerade projekten. Vi var inte helt medvetna om detta beteende förrän några projekt hade importerats och skapats. Problemet med flera anpassade fält för externa ärende-ID:n är att länkar mellan ärenden i olika projekt inte skapas.
En möjlig lösning är att använda ett mellanliggande projekt för att importera alla ärenden från Redmine, eventuellt i omgångar, och sedan massflytta dem till nya projekt. Lösningen bör fungera med båda metoderna för att importera ärendena.
När allt sedan har importerats till Jira kan du använda skriptet som beskrivs ovan för att skapa länkar mellan ärenden från olika projekt. Det spelar ingen roll att vissa av länkarna redan finns.
4. Slutresultat och reflektioner.
Ändringar i workflow
Om äldre projekt importeras till en befintlig Jira-instans kan det vara en bra idé att utvärdera hur de två verktygen har använts. Jira använder workflows för att styra hur ärenden kan flyttas mellan olika statusar och om det finns begränsningar för att ett ärende ska kunna gå igenom alla steg innan det kan stängas.
ScriptRunner
Som beskrivits ovan kan ScriptRunner hjälpa dig att justera data efter importen till Jira. Från början efterfrågades det endast för efterbearbetning av importerad data, men det visade sig också vara användbart för att ange villkor och efterfunktioner för övergångarna i workflows. Villkor och validerare kan användas för att förhindra samma statusar, till exempel stängda stories med öppna deluppgifter, vilket är ett av de medföljande skripten i ScriptRunner. Det finns funktioner som kan användas som efterfunktioner, till exempel för att stänga en överordnad story när alla deluppgifter har stängts. Eftersom ScriptRunner ger åtkomst till hela Jiras interna plugin-API, och inte bara REST API, går det att skriva funktioner som gör exakt det du behöver för ditt arbetssätt.
Överväg att investera i ScriptRunner
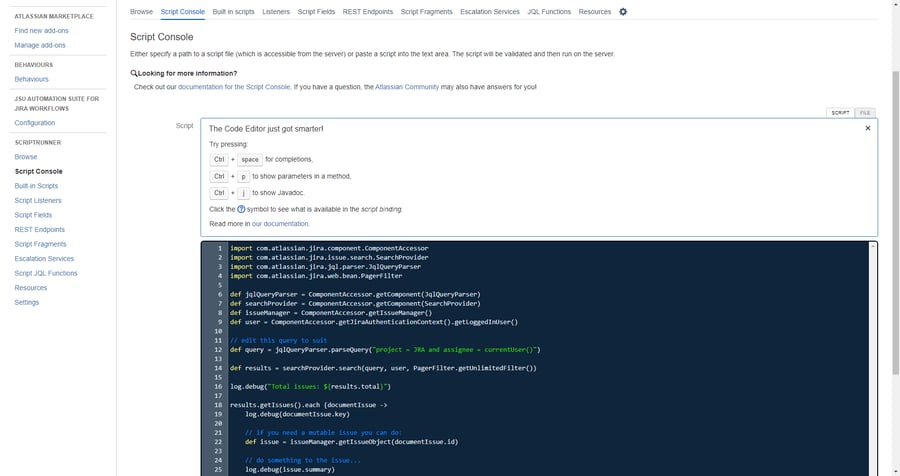
Innan du påbörjar en migrering från ett tredjepartsverktyg är det klokt att överväga att köpa tillägget ScriptRunner, eftersom det ger åtkomst till hela Jiras API via en konsol. REST API har vissa begränsningar, till exempel för sprintar där inte all metadata kan redigeras. Det är mycket kraftfullt för efterbearbetning av importerad data. Webben är full av kodsnuttar som kan redigeras och anpassas om du har viss programmeringserfarenhet. Konsolen erbjuder automatisk kodkomplettering. De ScriptRunner-kodsnuttar som vi använde i workflow och för efterbearbetning är öppen källkod och finns tillgängliga i Praqmas code-utils-repository. Följande kodsnutt kan användas som ett villkor för övergången till löst för att förhindra att stories stängs när de har öppna deluppgifter. Adaptavist har en bra guide om hur du skriver egna villkor för en övergång.
Även om du inte planerar att använda skriptkonsolen mer än vid några få tillfällen finns det JQL-funktioner som kan användas när du söker efter ärenden, och den kan även användas för att skapa nya anpassade JQL-funktioner.
Slutsats
I migreringsprocessen förenklade vi befintliga workflows så att alla team använde samma workflow.
Teamen började fullt ut använda Atlassians Scrum-funktioner, såsom epics och sprintar, i den Scrum-metodik som stöds av Jira.
Om vi skulle göra om det skulle vi utvärdera importpluginen mer noggrant. De gör ett helt okej jobb, men det tar tid att skriva skript som verifierar att data verkligen importeras korrekt. De kan dock lämna kvar vissa städuppgifter som kan undvikas genom att lägga mer tid på att skriva skript för att extrahera och anpassa data. Dokumentationen beskriver exakt hur fälten mappas när du använder importverktyget.
Det ursprungliga nummerschemat (externt ärende-ID) är viktigt av flera skäl. Det säkerställer att samma ärende inte kan importeras två gånger och fungerar som en länk mellan Jira och Redmine. Genom att endast ha ett anpassat fält för externt ärende-ID går det också att behålla länkarna mellan ärenden i olika projekt.
ScriptRunner visade sig vara mycket användbart både för städning och för de medföljande JQL-funktionerna som kan användas för frågor till tavlorna och vid sökning efter ärenden. Dessutom har vi använt det för ändringar i workflows.
- DevOps
- Atlassian
Subscribe to our newsletter
Related blogs


