
I det här blogginlägget beskriver vi varför team växer ur Infrastructure-as-Code-verktyg som Terraform och skalar upp sin användning av molnet med hjälp av kontrollplan som Crossplane.

Michael Vittrup Larsen
Michael is a Consultant at our office in Aarhus. He has an MScEE from Aalborg University where he specialized in digital signal processing. Before joining us Michael was working on building and optimizing cloud infrastructure for the telecoms sector. In his spare time, he likes to explore the wilderness on his mountain bike.
I sin keynote på Crossplane Community Day beskrev Bassam Tabbara, grundare och CEO på Upbound, på ett träffande sätt superkrafterna bakom Kubernetes:
”deklarativ hantering utifrån önskat tillstånd”
”automatiserad controllerlogik” för att synkronisera önskat tillstånd med faktiskt tillstånd
Den här driftsmodellen är en av anledningarna till att vi enkelt kan hantera hundratals beräkningsnoder och tusentals containrar, nätverk mellan dem, autoskalning och så vidare.
En annan anledning är att det deklarativa API:t fungerar på en användbar abstraktionsnivå som inte leder till kognitiv överbelastning. Med en Kubernetes Deployment kan vi till exempel definiera en container image och hur många repliker som ska köras. Därefter tar Kubernetes controllers hand om schemaläggning, övervakning, omstarter och så vidare.
Boken ”Cloud Native Infrastructure” av Justin Garrison och Kris Nova beskriver ”Cloud Native Infrastructure” som ”...infrastruktur som döljs bakom användbara abstraktioner och som, styrd av API:er, hanteras av mjukvara...”. Boken beskriver sedan reconciler-mönstret – själva kärnan i det här nya paradigmet som kallas ”Control planes” och som är på väg att ersätta mer traditionella Infrastructure-as-Code-verktyg som Terraform.

Källa: Bassam Tabbaras keynote, som nämns ovan
Komponerbarhet – en möjliggörare för skalbar molnanvändning
Det är avgörande att control planes erbjuder användbara abstraktioner. Molnplattformar är enorma och komplexa och erbjuder vanligtvis hundratals tjänster, var och en med många olika konfigurationer och inställningar.
Det här är en viktig begränsande faktor för användningen av molnet. Plattformsteam och SRE-team förväntas driva på molnanvändningen, men att kompetensutveckla alla utvecklare så att de kan dra nytta av molnet är i regel inte skalbart. När den ”genomsnittliga” utvecklaren tittar på molnet kan hen se detta – en mängd byggblock i olika storlekar och färger:
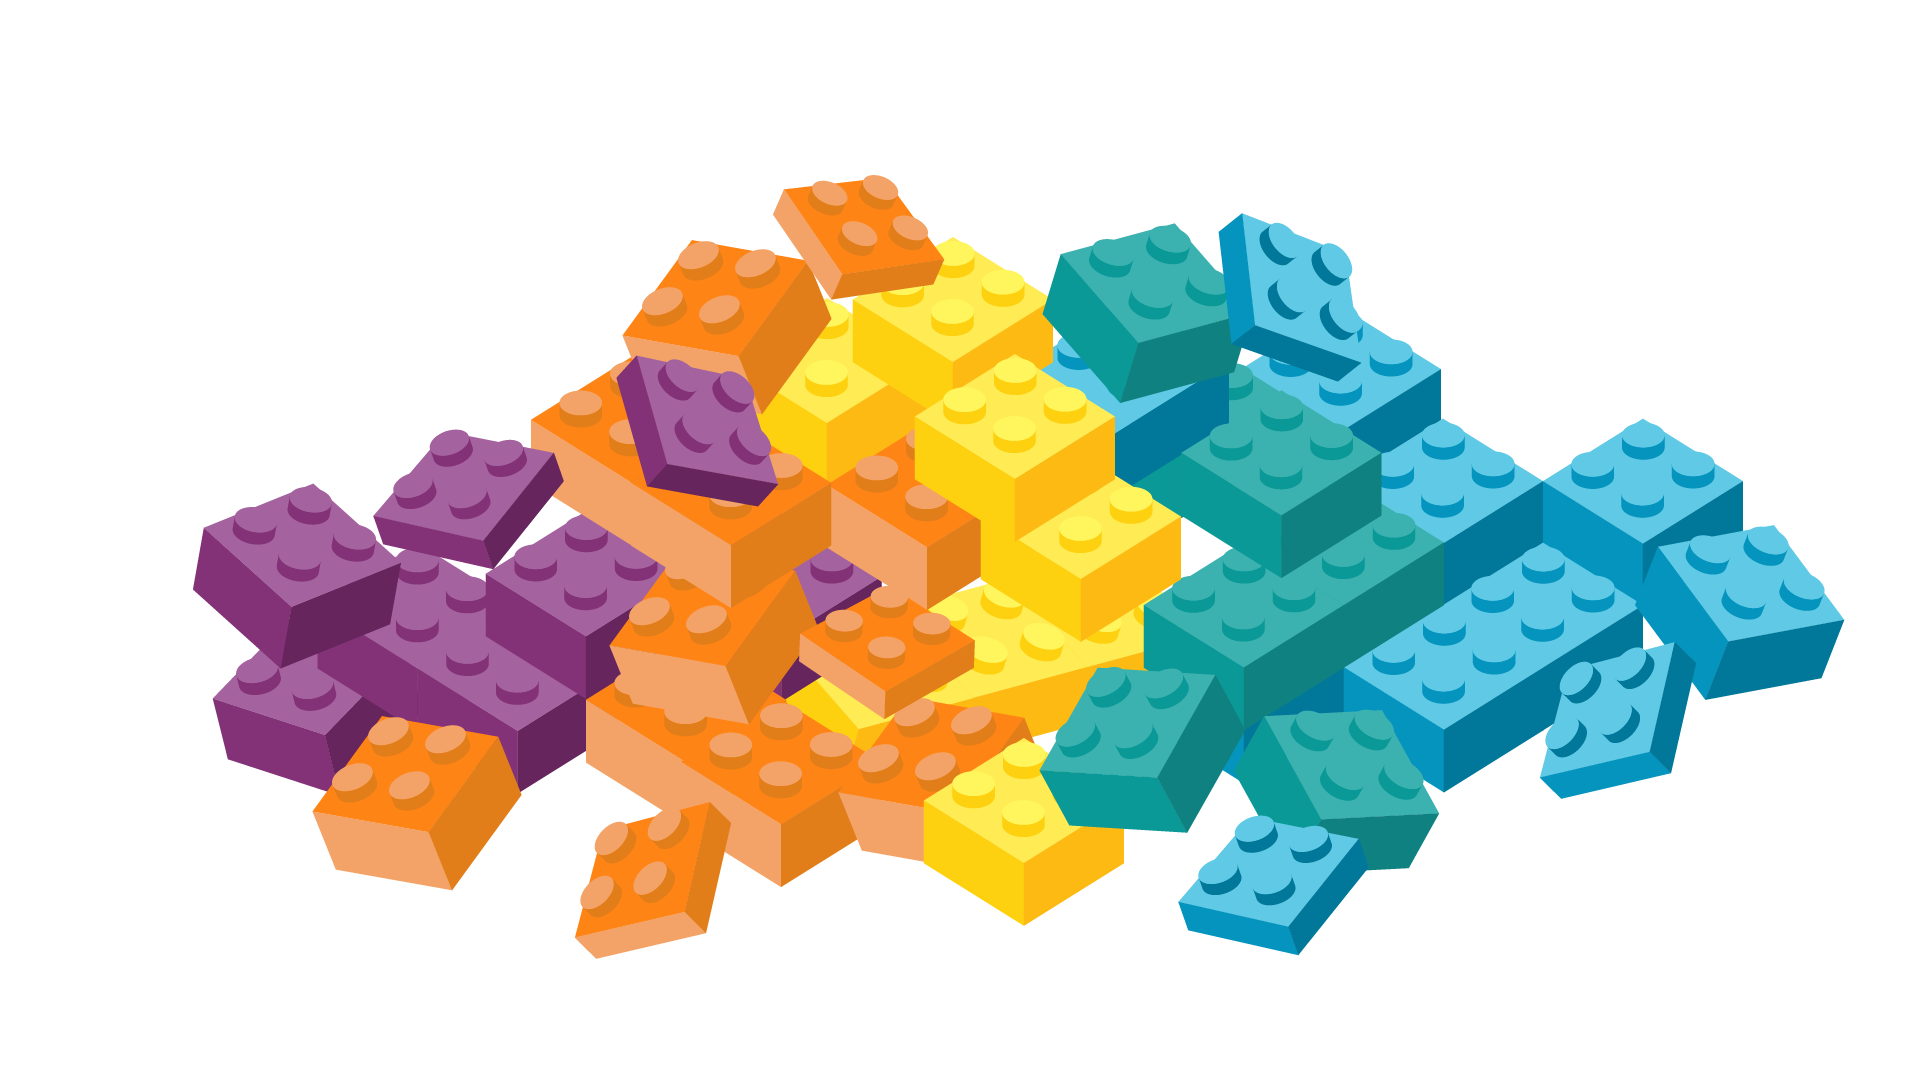
...men det de egentligen vill ha är bara följande, där den enda valfriheten är färgen:

Molnplattformens generalitet innebär att den inte erbjuder rätt abstraktionsnivå för merparten av utvecklarna. Kubernetes API tillhandahöll en abstraktion för beräkningsnoder, container runtimes som Docker, nätverk och lagring. Det gjorde det mycket enklare att driftsätta och driva applikationer ovanpå ett containerkluster.
Komponerbarhet är förmågan att bygga abstraktioner på högre nivå med hjälp av abstraktioner på lägre nivå och är avgörande för att skala användningen av all teknik – inklusive molnet. Men ta inte bara mitt ord för det, se vad Kelsey Hightower säger om Crossplane och komponerbarhet.
När Terraform inte längre räcker till
I Terraform-världen kommer komponerbarhet i form av moduler. Att använda Terraform-moduler är ett stort steg framåt, men de är bara mallar som genererar alla mindre komponenter. Att hantera plattformar som byggts av moduler övergår snabbt till att hantera de mindre komponenterna – Terraform-moduler är en mycket otät abstraktion!
Att hantera stora monolitiska infrastrukturer är besvärligt, och det åtgärdas ofta genom att dela upp infrastrukturen i mindre delar, även kallat en ”skiktad arkitektur”, där varje del är en fristående Terraform-plan och beroenden mellan skikten hanteras via ”remote state”.
Även om detta är bättre än en monolitisk arkitektur är det fortfarande skört och kräver noggrann manuell orkestrering av de enskilda skikten på grund av beroendena.
Terraform är i grunden ett verktyg som vi kör vid behov när vi vill uppdatera vår infrastruktur. Terraform automatiseras ofta med exempelvis Atlantis, som introducerar en GitOps/ChatOps-modell för Terraform. Detta hanterar dock inte drift eller reparationer av felaktiga infrastrukturkomponenter. Vi måste manuellt upptäcka sådana situationer och köra Terraform igen, eftersom modellen är händelsestyrd och inte bygger på en reconciliation loop i ett control plane.
När det gäller åtkomstkontroll innebär GitOps-modellen att alla med åtkomst till vårt Git-källkodsförråd kan ändra vår infrastruktur. Vi kan inte särskilja vem som får göra vad utifrån den abstraktion som är relevant för oss. Vi kan försöka utforma identiteter för att köra Terraform, till exempel IAM-roller med separerade behörigheter, men eftersom detta bygger på den underliggande molnresursmodellen är det mycket svårt att få rätt.
Det här går tillbaka till att Terraform-moduler är otäta abstraktioner. I stället vill vi att åtkomstkontroll ska definieras utifrån den abstraktionsnivå där vi arbetar. I Kubernetes handlar RBAC-modellen om resurser som Deployments och Pods i olika namespaces, och vi behöver inte bry oss om hur containrar schemaläggs på beräkningsnoder eller hur nätverkssegregering implementeras med IP-tables och så vidare.
Se även vad Nic Cope på Upbound säger om Terraform jämfört med Crossplane – han uttryckte det mycket bättre än jag kan.
Motverka motviljan mot förändring
Att använda control planes innebär att ge upp en del kontroll. Därför kan erfarna SRE-team känna tvekan inför att lita på control plane. Vi behöver fortfarande se hur exempelvis Crossplane presterar i skarpt läge, men vi kommer så småningom även att använda control planes för molnet. Att inte distraheras av detaljer utan i stället abstrahera bort dem och låta ”maskinerna” hantera detaljerna är en naturlig utveckling inom teknik.
Vi har sett detta hela vägen från operativsystem och kompilatorer till containerplattformar som Kubernetes. Eftersom vi vet att detta är den oundvikliga utvecklingen bör vi välkomna control planes. Om Crossplane inte hittar rätt balans och abstraktionsnivå kommer nästa control plane att göra det.
Att förändra den mentala modellen för infrastruktur
Ops- och SRE-team kan vara oroliga för hur de kan säkerställa drifttid och tillgänglighet med kontrollplanens modell för ”eventual consistency”.
Det är en befogad oro och pekar på ett annat vanligt anti-mönster i dagens infrastrukturdesign. Många organisationer har till exempel Kubernetes-kluster för ”dev”, ”stage” och ”production”. Om vi till exempel ändrar önskat tillstånd för ”production”-klustret: hur garanterar vi att våra slutanvändare inte upplever att våra applikationer ligger nere medan kontrollplanet – som vi avsiktligt har mycket begränsad kontroll över – konsoliderar det nya tillståndet? Oron är befogad, men frågan är fel!
Oron beror på att vårt ”production”-kluster är ett husdjur, inte boskap.
Med Kubernetes lärde vi oss att gå från enskilda serverhusdjur till utbytbara containrar, det vill säga att egenskaper som drifttid och tillgänglighet hanterades genom att Kubernetes orkestrerade flera containrar. Framåt behöver vi lära oss att tillämpa samma modell på all infrastruktur.
Vi bör inte designa för ett enda ”production”-kluster. I stället bör vi inse att vi när som helst kan ha flera ”production”-kluster och ta hänsyn till det i vår design – ungefär som vi tar Kubernetes Deployments och Services för givna och låter Kubernetes Control plane hantera all komplexitet kring att hantera enskilda containrar och vår applikations övergripande egenskaper.
- DevOps
- Moln
- CI/CD
Subscribe to our newsletter
Related blogs


