
Olemme jo jonkin aikaa keskustelleet OpenAI:stä, erilaisista mahdollisista käyttötapauksista ja siitä, mitä voisimme sillä tehdä. Lähes aina ongelmana oli, että käyttötapaus vaati tiettyä dataa tai sen oikeellisuutta oli vaikea todistaa.

Kalle Sirkesalo
Field CTO
Kalle sits at the intersection of executive strategy and engineering reality. He works directly with CTOs and engineering leaders to translate business pressures — speed, compliance, ROI — into technical decisions that actually hold. His job is to make sure what we recommend is something your organization can actually execute.
Tekoälyn liiketoimintaperusteen rakentaminen
Uuden teknologian kanssa on tärkeää päästä nopeasti alkuun, joten halusimme tehdä mahdollisimman yksinkertaisen liiketoimintaperusteen. Huolellisen hienosäädön ja työn jälkeen päädyin siihen, että meidän täytyisi tietää, kuka on tehnyt tämän aiemmin. Yksinkertainen kysymys, johon on usein useita vastauksia.
Meillä tämä voidaan teoriassa tehdä JQL:llä, koska kaikki data on Jira Service Managementissa, mutta se huomioi vain assignee-kentän eikä esimerkiksi Tempon ajanseurantadataamme.
Kun siis kysyt tekoälyltä: ”Kuka on työskennellyt aiemmin Exalaten kanssa?”, saat 10 nimeä ja tiedät, keneltä pyytää apua. Arvelimme, että jos tähän kysymykseen voidaan vastata, se säästäisi tunteja kuukaudessa, sillä usein tarvitset vain oikean henkilön auttamaan pääsemään alkuun tapauksen kanssa. Markkinointitiimillämme on minulle lisää liiketoimintaperusteita, joihin kuuluu ”25 yleisintä ongelmaa”. Jos pystymme vastaamaan tähän kysymykseen, he ovat tyytyväisiä.
Azure OpenAI ja oman datan käyttöönotto
Nopea hahmotelma-arkkitehtuuri siitä, mitä tarvitsemme Azure OpenAIta varten.
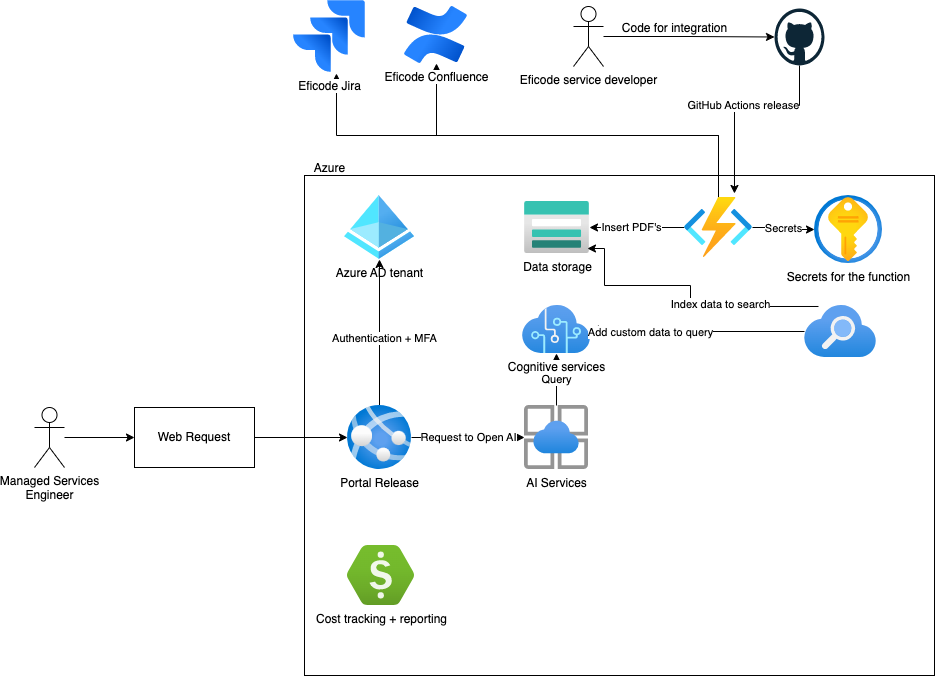
Azure OpenAI -lopputulos näyttää tältä, kun testaat dataasi ja chatia ennen sen julkaisemista muiden käyttöön. Komponentteja on siis vähän.
Tässä osiossa keskitymme Cognitive Servicesiin, Azure Searchiin, Blob Storageen ja AI Studioon. Sen jälkeen tarkastelemme integraatioita ja lopuksi puhumme tekoälysi julkaisemisesta.
Kaikki alkaa siitä, että haet OpenAIta organisaatiosi käyttöön. Tämä edellyttää lomakkeen täyttämistä ja sitoutumista eettisten tekoälyohjelmien noudattamiseen. Näin Azure OpenAI otetaan käyttöön tilauksellasi. Sen jälkeen voimme alkaa työstää tuotetta. Aloitin siirtymällä Azure OpenAI Studioon ja avaamalla Chat playgroundin ensimmäistä kyselyä ja testausta varten. Näet alla lopputuloksen tekoälyn kanssa keskustelemisesta.
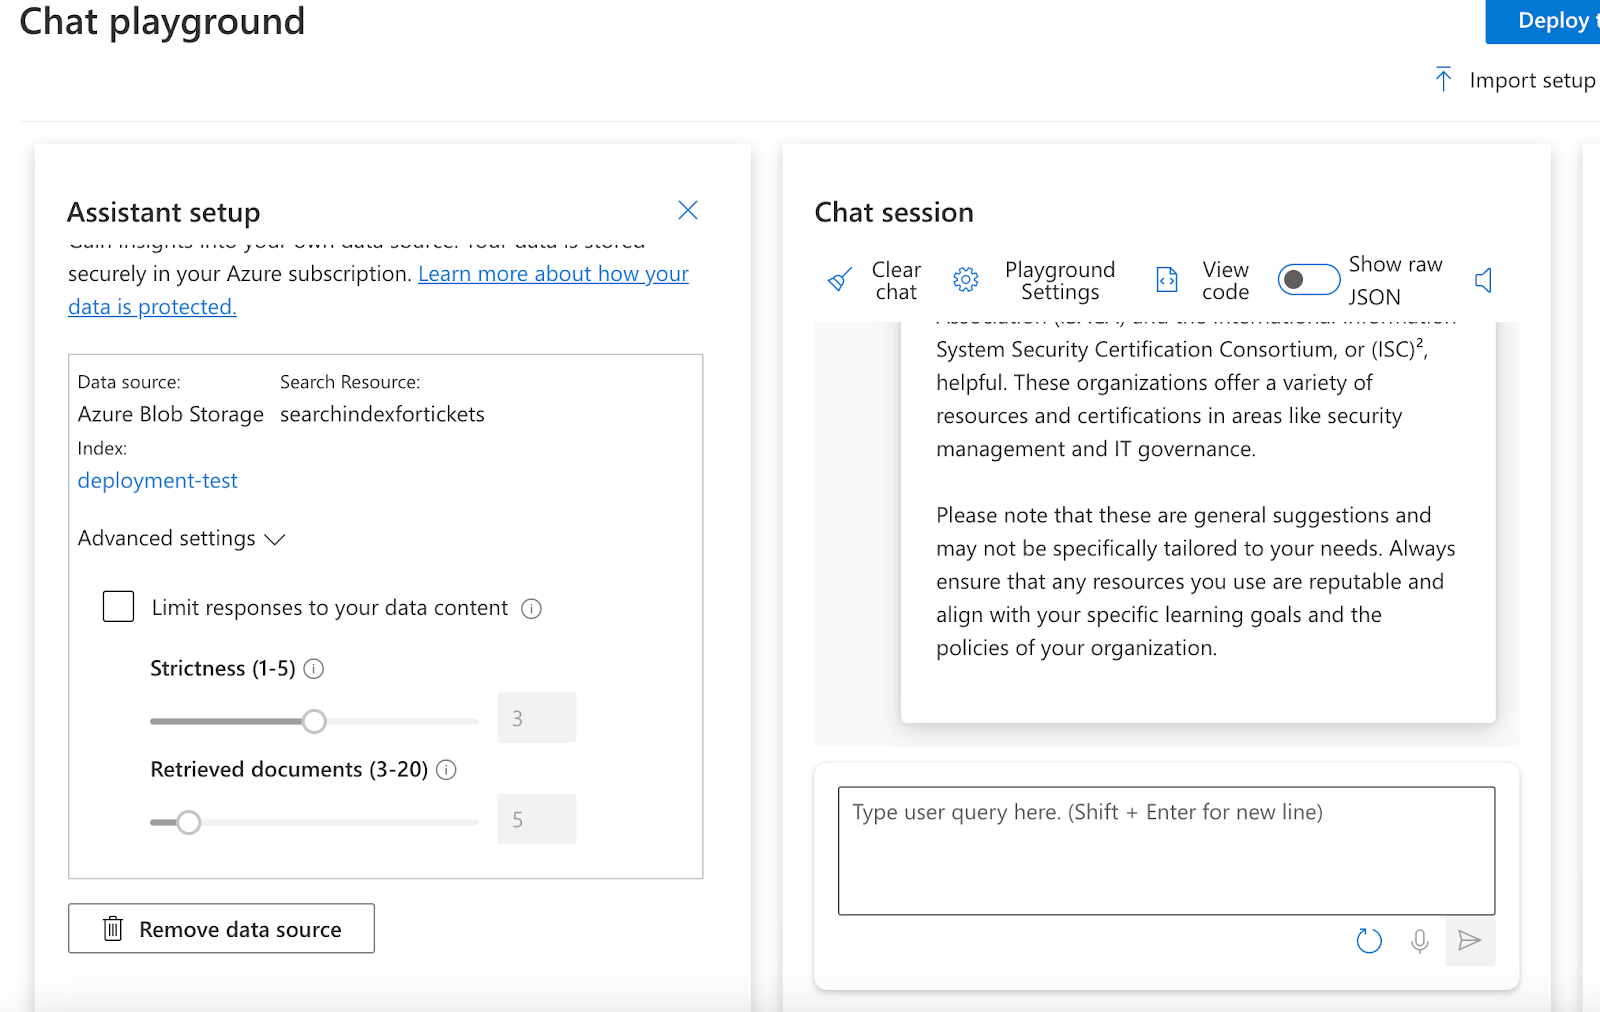
Kuten vasemmalta näet, siellä on kenttä datallemme. Kyseessä on julkisessa esikatselussa oleva ominaisuus, jolla voit tuoda omaa dataasi järjestelmään. Sen käyttöönottoa varten datasi on oltava Azuressa jollakin hyväksytyistä tavoista: tällä hetkellä Azure Searchissa (Blob Storage), Azure CosmosDB:ssä tai datan URL-osoitteena/linkkinä. Me otimme ensin käyttöön Azure Blob Storagen ja loimme datalle säilön. Datan on oltava tietyssä muodossa; suosittelen .pdf-muotoa.
Ennen kuin voimme käyttää dataa, se on indeksoitava ja tehtävä haettavaksi, joten meidän on otettava käyttöön Azure Search -palvelu.
OpenAI Studiossa hakuindeksejä ei voi käyttää uudelleen, vaan ne on rakennettava joka kerta uudelleen. Tämä muodostuu ongelmaksi suuremmilla datajoukoilla, joten suosittelen aloittamaan pienestä ja määrittämään käyttöliittymässä ajastetun indeksoinnin käynnistymään esimerkiksi päivittäin. Tuotantosovelluksessasi (lisää tästä myöhemmin) otat käyttöön olemassa olevan indeksin. Näin voit käyttää suurempaa datajoukkoa ilman kahdeksan tunnin odotusta – opin tämän kantapään kautta.
OpenAI Search omalla datallasi ei kouluta mallia. Kuten yllä näkyy, se hakee Azure Searchista, palauttaa X määrän dokumentteja (yllä olevassa kuvassa 5) ja muodostaa vastaukset näiden dokumenttien perusteella lisäämällä ne valitsemaasi malliin ja generoimalla vastauksen. Huomio: Yllä olevassa kuvassa GPT-datasarjan sisällyttämistä rajoittavana tekijänä ei ole otettu käyttöön.
Tämä tarkoittaa, että kannattaa tarjota pieniä tiedostoja suurempia tiedostoja, mistä puhumme Jiraa käsittelevässä osiossa. Saan näin todella hyviä vastauksia tarkkoihin kysymyksiin, mutta laajempiin kysymyksiin vastaukset eivät tietenkään ole hyviä, koska datajoukko, josta tietoa haetaan, on yleensä hyvin suppea.
Tästä vaiheesta käytetään usein nimitystä RAG:n eli Retrieval Augmented Generationin rakentaminen. Termin loi Facebookin AI-tiimi, ja siinä LLM-malli (Large Language Model, esimerkiksi ChatGPT:n GPT3.5 tai GPT4) yhdistetään hakukoneeseen eli tietopankkiin.
Kahta seuraavaa vaihetta kutsutaan KB:n eli tietopankin rakentamiseksi. Niissä rakennamme hakukonedatan ja indeksit, jotta edellä mainittu hakukone voi toimia.
Oman datan tuominen Confluencesta
Nyt kun meillä on tapa testata ja käyttää tekoälyämme, miten voimme tuoda mukaan merkityksellistä analysoitavaa dataa?
Haluamme saada vastauksia omasta datastamme ja koota tietoa, jota ihmiset etsivät. Ensimmäisenä halusin tuoda datan Confluencesta. Koska suurin osa Confluencen datasta on melko staattista, valitsin nopeaksi ratkaisuksi space exportit, sillä tarvitsin vain noin 10 spacea, jotta tekoälyni alkaisi antaa vastauksia.
Nopeaa PoC:tä varten latasin ne manuaalisesti AI:n Blob Storageen. Näin sain palvelun käyttöön alle tunnissa siitä, kun Microsoft oli hyväksynyt OpenAI-käytön. Tämä nopea demo julkaistiin sitten alla luetelluilla tavoilla eri lähestymistapojen testaamiseksi.
Tuotantoa varten rakennamme kunnollisen dataputken, jossa viemme datan Confluencesta Azure-datatyökaluilla. Työ on parhaillaan käynnissä, ja siitä julkaistaan myöhemmin erillinen blogikirjoitus. Confluence ei tällä hetkellä mahdollista automaattisia space exporteja pilvessä, joten et voi automatisoida sitä suoraan, vaan tarvitset räätälöidyn ratkaisun, kuten ScriptRunner for Confluencen.
Space exportin dataformaatti vaikutti erittäin hyvältä OpenAI-käyttöön, joten suosittelen, ettet lataa sivuja erikseen vaan suurempana kontekstina, kokonaisina space exporteina.
Oman datan tuominen Jirasta
Miten Jira-datan testaaminen edes aloitetaan? Mitä minun täytyy tehdä? Miten data jäsennetään? Mikä on nopea PoC? Pohdin näitä kysymyksiä, koska liiketoimintaperusteeni riippui Jira-datasta. En oikein ymmärtänyt edellä mainitsemaani datan valmistelua, eli sitä, että datan tulisi olla laajoina kokonaisuuksina.
Python on minulle tuttu kieli, joten päädyin kirjoittamaan skriptin, joka hakee kaikki tiketit JQL-kyselyllä käyttäen Jiran henkilökohtaista käyttöoikeustunnustani ja siirtää ne Blob Storageen. Kirjoitin skriptin tukemaan .txt-tiedostojen tallennusta Blob Storageen, mutta Cognitive Searchin ongelmien vuoksi .txt-tiedostot eivät toimineet, joten kirjoitin toisen skriptin muuntamaan .txt-tiedostot .pdf-muotoon. Tarkistukseni perusteella tämän pitäisi olla kunnossa, mutta koska .pdf-datani toimii, en ole varmistanut asiaa samalla datajoukolla.
Päädyin siirtämään järjestelmään 60 000 tikettiä, mikä johti indeksoijan aikakatkaisuun oletusasetuksilla. Kuten edellä kuvattiin, indeksoi ensin pienempi erä ja määritä indeksoijan aikakatkaisut ja välimuistit ennen suuren datamäärän siirtämistä. Näin voit myös tallentaa datan oikeaan järjestykseen. Suosittelen ajamaan skriptin palvelimella tai Azure Functionissa.
Skriptini ajo Jira-palvelinta vasten kesti kuusi tuntia. Jira-tikettiä kohden tehtävien kyselyiden määrä on huomattava: ensin data on haettava JQL-kyselyllä, sitten on kyseltävä tiketin tiedot mukautettuja kenttiä ja yksityiskohtaisia tietoja varten, haettava kommentit ja omassa tapauksessani noudettava työaikatiedot Tempo API:sta. Kun sivutus oli 50 tikettiä kerrallaan ja jokaista tikettiä kohden tehtiin yhteensä kolme API-kyselyä, yksi skriptiajo teki noin 200 000 API-pyyntöä Jiraan.
Työskenneltyäni enemmän OpenAI:n kanssa muuttaisin tämän ehkä projektikohtaiseksi indeksoinniksi, jotta vastaukset perustuisivat laajempaan projektikontekstiin tikettikontekstin sijaan. Tikettikonteksti tuottaa erittäin tarkasti rajattuja vastauksia, mikä tarkoittaa, että myös OpenAI:lle esitettävien kysymysten on oltava yhtä tarkkoja. En kuitenkaan ole testannut hakua projektitasolla.
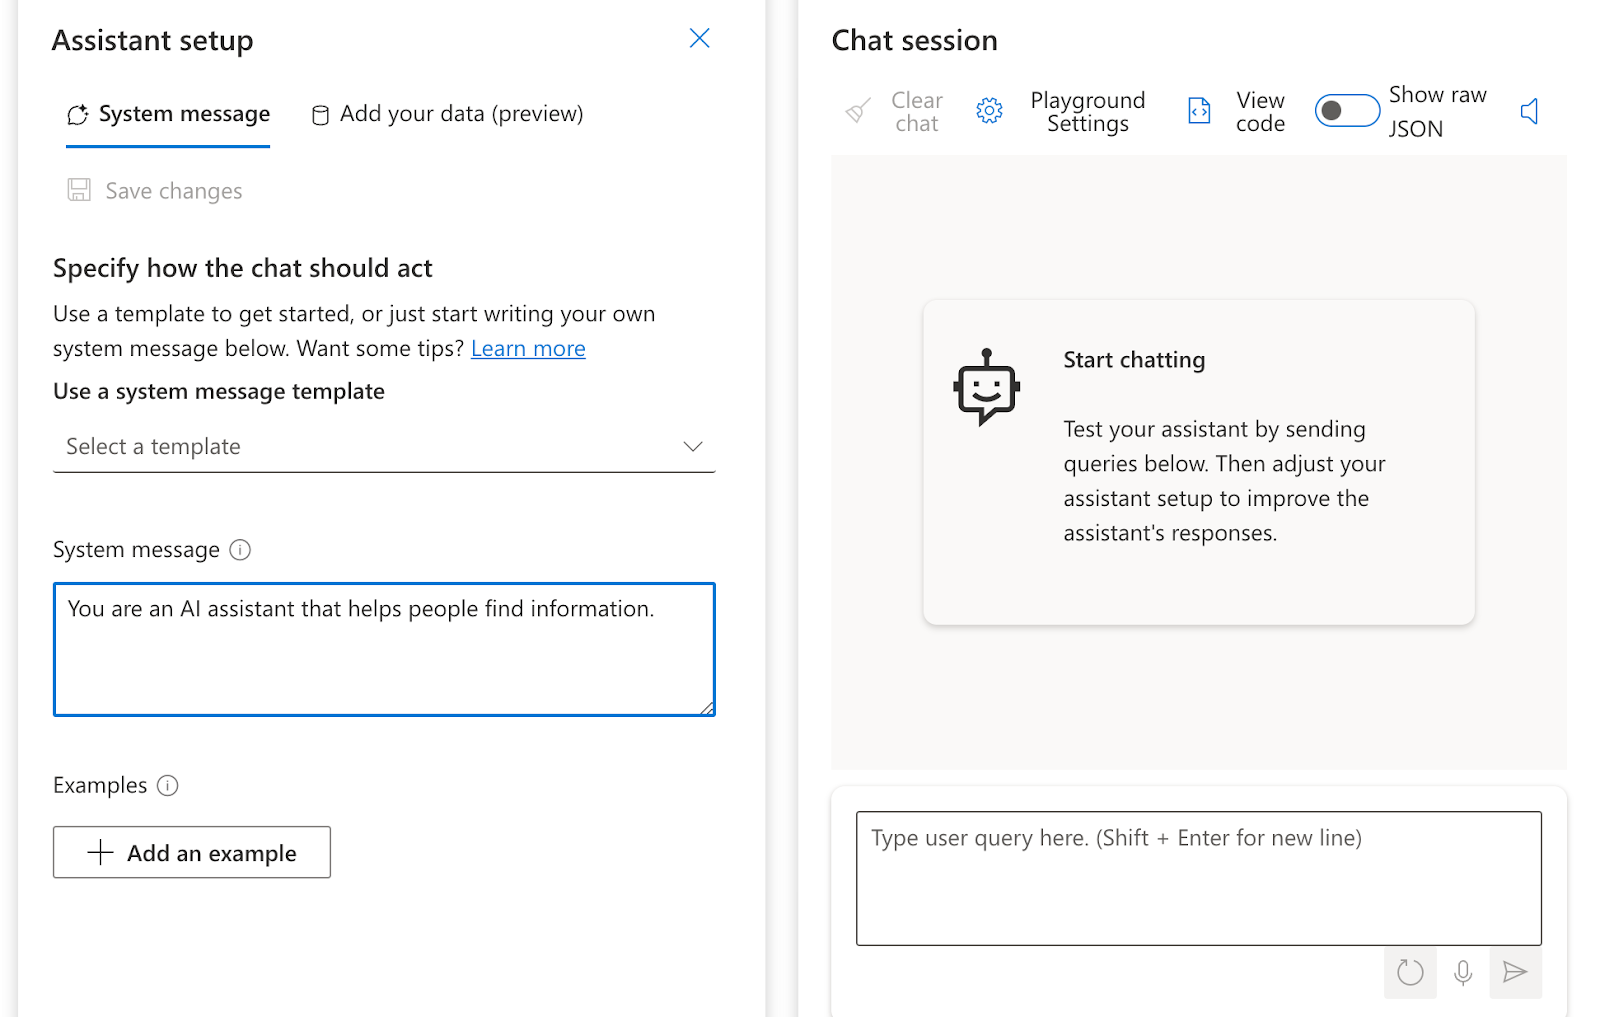
Voit hienosäätää haun datallesi sopivaksi muuttamalla järjestelmäviestiä vastaamaan paremmin tekoälysi tarpeita. Oletuksena siinä lukee: ”Olet tekoälyavustaja, joka auttaa ihmisiä löytämään tietoa.” Tämä toimii näissä käyttötapauksissa varsin hyvin, mutta paremmalla pohjustuksella voit saada parempia tuloksia. Jos tekoälysi ei toimi oikein tai haluat hienosäätää sen vastaustapaa, tämän muuttaminen voi vaikuttaa tuloksiin merkittävästi. Olemme esimerkiksi nähneet, miten käyttökelvoton botti on muuttunut toimivaksi.
Azure OpenAI Studion tuominen yleisöni käyttöön
Nyt meillä on Azure OpenAI Studiossa kaksi erilaista chat-ikkunaa, ja haluan alkaa julkaista niitä. Aluksi ajattelin ottaa käyttöliittymän automaattisesti luoman koodin ja rakentaa Slackbotin, mutta kollegani huomautti, että Danswer voisi olla ratkaisu, sillä se integroituu automaattisesti Slackiin ja Azure OpenAI:hin.
Sain Danswerin nopeasti toimimaan ottamalla sen käyttöön kannettavallani heidän pikaoppaan avulla ja mukauttamalla sen käyttämään Azure OpenAI:tani analysointiin. Harmillista oli, ettei se tällä hetkellä tue Azure Searchia yhtenä dokumenttien indeksoijista, joten en voinut käyttää sitä omaan käyttötapaukseeni. Ratkaisujen kehityksestä innostuneena ajattelin kuitenkin: ”Ehkä minun pitäisi kokeilla Microsoftin pikakäyttöönottopainiketta.” Valitettavasti bottikehys toimii tällä hetkellä vain Teamsissa, ja koska emme käytä Teamsia viestintään, päätin kokeilla verkkosovelluksen käyttöönottoa. Se osoittautui juuri etsimäkseni ratkaisuksi!
Saat käyttöösi erittäin yksinkertaisen käyttöönotto-lomakkeen, ja 10–15 minuutin kuluttua sinulla on toimiva chat-ikkuna. Azure AD -todennus estää luvattoman käytön, ja voit myös hallita, kenellä on pääsy käyttöliittymään.
Sain erittäin nopean tavan antaa loppukäyttäjiemme testata käyttötapauksia. (Katso alta, miten sovellus otetaan käyttöön. Huomaa, että historiatiedot vaativat CosmosDB:n, mikä maksaa noin 5 000 dollaria kuukaudessa. Liiketoimintaperustelua varten suosittelen säästämään rahaa haastattelemalla loppukäyttäjiä, ellet ole viemässä ratkaisua suoraan tuotantoon sadoille käyttäjille.)

Toimiko liiketoimintaperusteluni?
No, toimiko se? Rehellisesti sanottuna omasta mielestäni ei, mutta loppukäyttäjien näkökulmasta kyllä, sillä he ovat olleet tyytyväisiä.

Mitä seuraavaksi? Seuraan Azure Entrasta kirjautumisia ja palvelun käyttöä ymmärtääkseni, ketkä asiantuntijoistamme käyttävät sitä ja miksi. Yksi asiantuntijoistamme otti OpenAI-koodin ja kehittää integraatiota Jiraan, jotta voisimme luokitella kohtaamamme tiketit ja toivottavasti luoda uusia liiketoimintaratkaisuja. Mikä toimi? Azure OpenAI -palvelun käytön aloittaminen on nopeaa, ja pääsin verkkosovelluksen avulla ”tuotantoon” hetkessä testaamaan datajoukkoja asiantuntijoidemme kanssa.
Mitä toivon voivani työstää seuraavaksi: datan muotoa ja datan pohjustamista. Asiantuntijoiden kanssa tekemiemme nopeiden arvioiden perusteella ratkaisu toimii hyvin tietyillä alueilla, mutta antaa virheellistä tietoa väärin pohjustetun datan tai esimerkiksi Azure OpenAI:n/LLM:n, kuten ChatGPT:n, tekemien oletusten vuoksi. Totuus kuitenkin on, ettei se ole tietokanta. Se ei aggregoi tai analysoi dataa eikä luo valmiita raportteja. Nämä asiat on tehtävä JQL-/tietokantatasolla, koska kyse on datan aggregoinnista. Se voi kuitenkin kertoa, miten vastasimme tähän tikettiin viime kerralla.
Kaiken kaikkiaan suhtaudun toiveikkaasti ja luottavaisesti siihen, että voimme luoda tällä pitkällä aikavälillä arvoa asiantuntijoillemme ja asiakkaillemme. Se ei kuitenkaan ole taikaratkaisu, vaan vaatii aikaa ja keskittymistä ymmärtääksemme, mitä olemme tekemässä. Hyvää uutta vuotta – toivottavasti sait inspiraatiota kokeilla Azure OpenAI:ta omalla datallasi.
- DevOps
- Eficode ROOT
- Atlassian
Subscribe to our newsletter
Related blogs


