
Vi har under en tid pratat om OpenAI, olika möjliga användningsområden och vad vi skulle kunna göra med det. Nästan alltid har problemet varit att användningsområdet krävt specifik data eller att det varit svårt att bevisa att resultatet skulle bli korrekt.

Kalle Sirkesalo
Field CTO
Kalle sits at the intersection of executive strategy and engineering reality. He works directly with CTOs and engineering leaders to translate business pressures — speed, compliance, ROI — into technical decisions that actually hold. His job is to make sure what we recommend is something your organization can actually execute.
Bygga ett business case för AI
Med ny teknik är det viktigt att komma igång snabbt, så vi ville skapa ett så enkelt business case som möjligt. Efter noggrann finjustering och arbete kom jag fram till att vi behövde veta vem som har gjort detta tidigare. En enkel fråga, men ofta med flera svar.
För oss kan det teoretiskt göras med JQL, eftersom all data finns i Jira Service Management, men det tar bara hänsyn till fältet för tilldelad person och inte till exempel vår tidsrapporteringsdata från Tempo.
Genom att fråga AI:n: ”Vem har arbetat med Exalate tidigare?” skulle du få 10 namn och veta vem du ska be om hjälp. Om detta går att besvara tänkte vi att det skulle spara flera timmar per månad, eftersom du ofta bara behöver rätt person för att komma igång med ett ärende. Vårt marknadsteam har fler business case åt mig, bland annat ”de 25 vanligaste problemen”. Om vi kan besvara den frågan blir de nöjda.
Azure OpenAI och en lösning för din egen data
En snabb arkitekturskiss som visar vad vi behöver för Azure OpenAI.
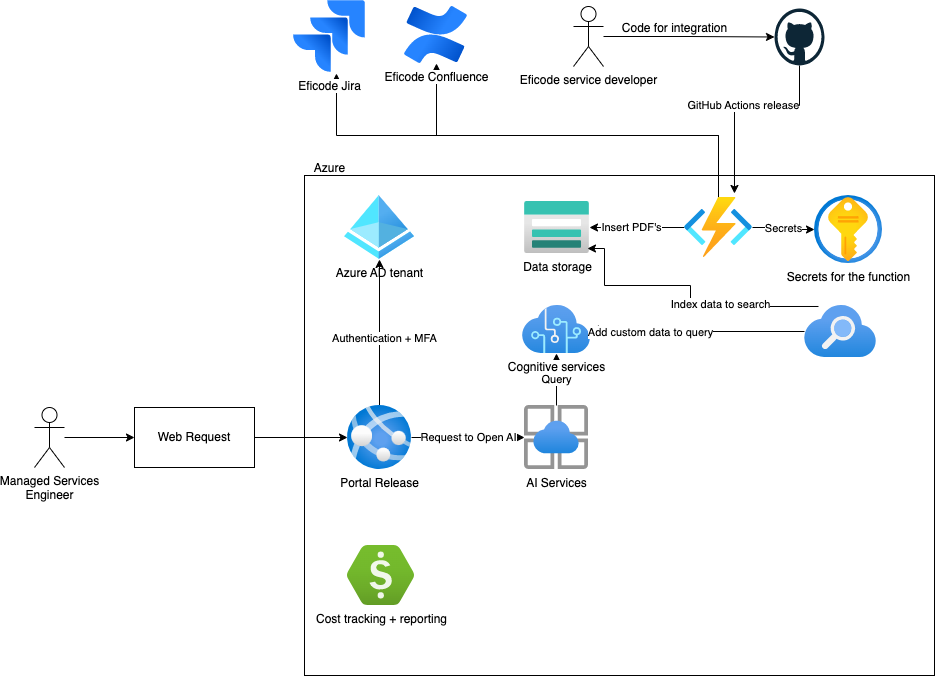
Slutresultatet i Azure OpenAI ser ut så här när du testar din data och chatt innan du släpper lös den i det vilda. Det innebär att vi har få komponenter här.
I det här avsnittet fokuserar vi på Cognitive Services + Azure Search med Blob Storage och AI Studio. Sedan tittar vi på integrationerna och avslutar med att prata om hur du lanserar din AI.
Allt börjar egentligen med att ansöka om att få OpenAI tillgängligt för din organisation, vilket kräver att du fyller i ett formulär och godkänner att följa etiska AI-program. Detta aktiverar Azure OpenAI för din prenumeration. Därefter kan vi börja arbeta med produkten. Jag började med att gå till Azure OpenAI Studio och öppna Chat playground för vår första fråga och test. Du kan se slutresultatet av chatten med AI:n nedan.
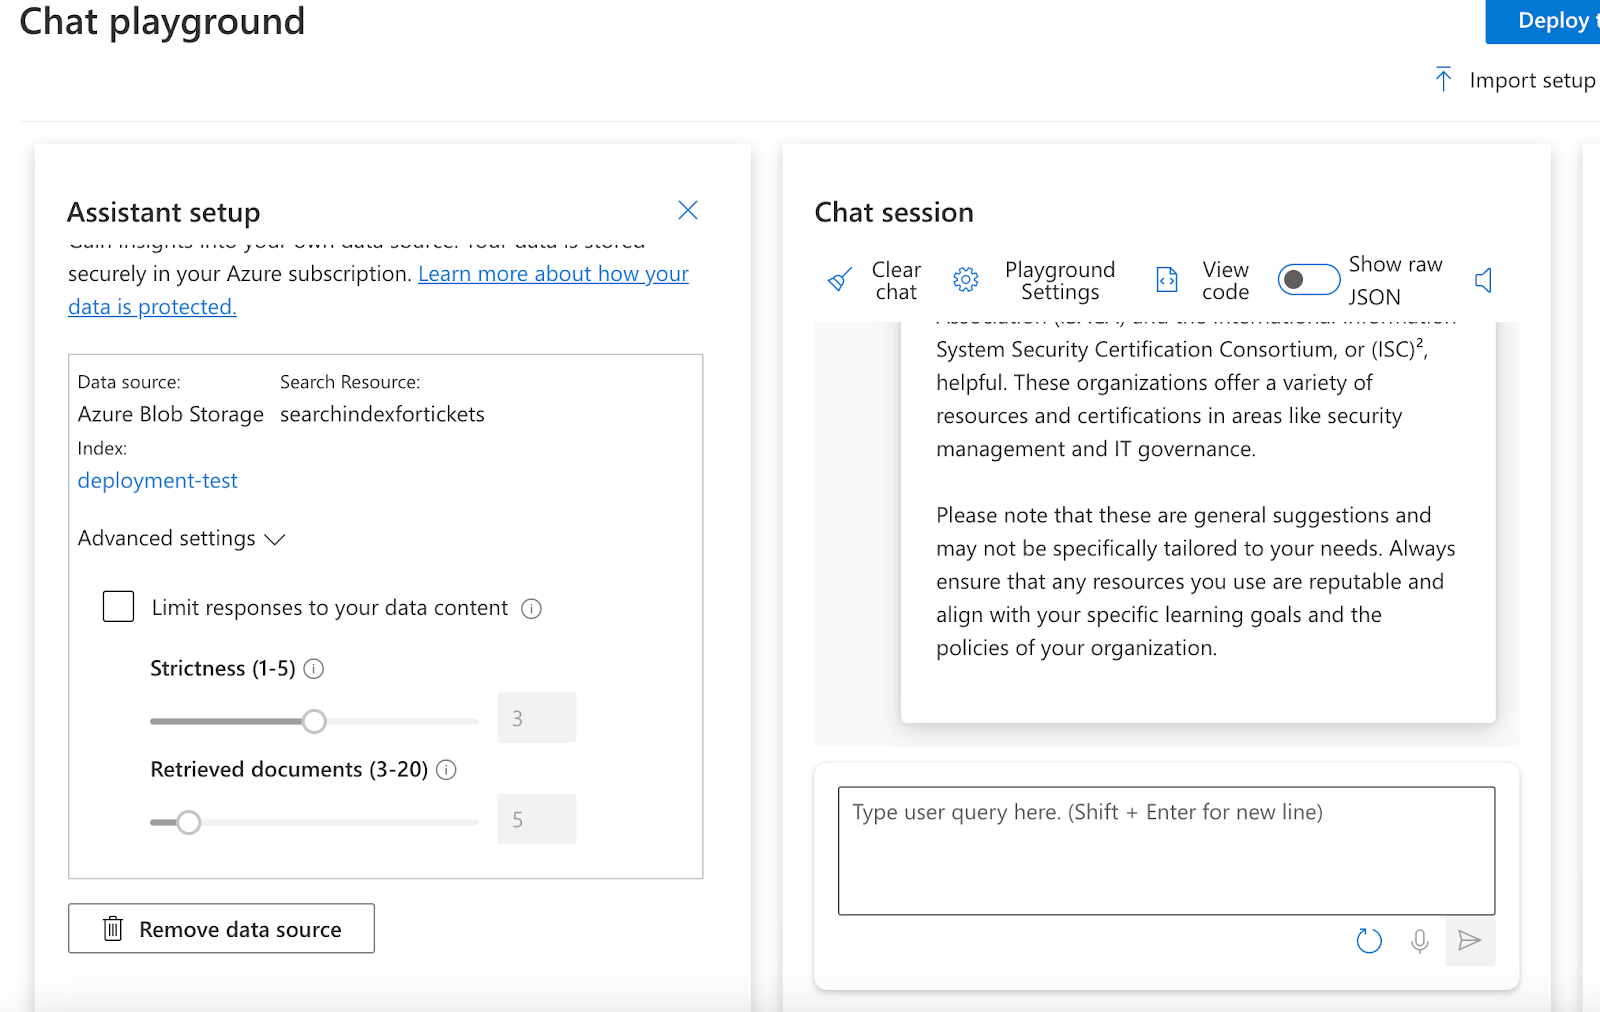
Som du kan se till vänster finns det ett fält för vår data. Det här är funktionen i offentlig förhandsversion som låter dig ta med din egen data till systemet. För att konfigurera detta måste din data finnas i Azure på något av de godkända sätten: för närvarande Azure Search (Blob Storage), Azure CosmosDB eller en URL/länk till datan. Vi började med att konfigurera Azure Blob Storage och en container för datan. Datan måste ha ett specifikt format; jag rekommenderar .pdf.
Innan vi kan använda datan behöver den indexeras och vara sökbar, så vi behöver driftsätta tjänsten Azure Search.
I OpenAI Studio kan du inte återanvända sökindexen, utan de måste byggas om varje gång. Det blir ett problem för större datamängder, så jag rekommenderar att du börjar i liten skala och ställer in schemalagd indexering i gränssnittet, till exempel dagligen. I din produktionsapplikation (mer om det senare) använder du sedan det befintliga indexet, vilket gör att du kan använda en större datamängd utan att behöva vänta åtta timmar (det lärde jag mig den hårda vägen).
OpenAI Search med din egen data tränar inte modellen. Som du kan se ovan söker den i Azure Search, returnerar X antal dokument (5 i bilden ovan) och skapar svar baserat på dessa dokument genom att lägga in dem i den modell du har valt och generera svaret. Obs: Bilden ovan visar att GPT-datauppsättningen har inkluderats eftersom begränsningen inte har aktiverats.
Det betyder att du bör tillhandahålla större filer i stället för små filer, vilket vi kommer att prata om i avsnittet om Jira. För mig ger detta riktigt bra svar på specifika frågor, men bredare frågor blir naturligtvis inte lika bra eftersom den datauppsättning som hämtas oftast är väldigt kort.
Den här fasen kallas ofta för att bygga RAG, eller Retrieval Augmented Generation. Begreppet myntades av Facebook AI-teamet och innebär att vi tar en LLM-modell (Large Language Model, till exempel ChatGPT:s GPT3.5 eller GPT4) och kopplar den till en sökmotor (kunskapsbas).
De nästa två faserna kallas att bygga KB, eller kunskapsbasen, där vi bygger sökmotordatan och indexen så att den ovan nämnda motorn kan fungera.
Ta in din egen data från Confluence
Nu när vi har ett sätt att testa och köra vår AI, hur kan vi tillföra meningsfull data att analysera?
Vi vill börja få svar från vår egen data och bygga upp den information som människor söker efter. Confluence var det första stället där jag ville ha data. Eftersom merparten av datan i Confluence är ganska statisk valde jag exporter av spaces som en snabb lösning, eftersom jag bara behövde cirka 10 spaces för att min AI skulle börja ge svar.
Jag laddade upp dem manuellt till Blob Storage i AI för en snabb PoC, vilket gjorde att jag kunde få tjänsten att fungera på under en timme efter att Microsoft godkänt användning av OpenAI. Den här snabba demon driftsattes sedan på de sätt som listas nedan för att testa olika angreppssätt.
För produktion kommer vi att bygga en ordentlig datapipeline där vi exporterar data från Confluence via Azure-verktyg för datahantering. Detta håller på att byggas och kommer att beskrivas i ett separat blogginlägg senare. Confluence tillåter för närvarande inte automatiska exporter av spaces i molnet, så du kan inte automatisera det direkt utan behöver en anpassad lösning, till exempel ScriptRunner for Confluence.
Dataformatet för export av spaces verkade fungera riktigt bra för OpenAI, så jag rekommenderar att du inte laddar upp sidor separat utan i stället använder det större sammanhanget från fullständiga exporter av spaces.
Ta in din egen data från Jira
Hur börjar man ens testa Jira-data? Vad behöver jag göra? Hur strukturerar jag den? Vad är en snabb PoC? Jag funderade på de här frågorna eftersom mitt business case hängde på Jira-datan. Jag förstod inte riktigt den datapreparering som jag nämnde ovan, alltså att datan bör omfatta större helheter.
Python är ett välbekant språk för mig, så jag skrev ett skript som hämtar alla ärenden med en JQL-fråga och min personliga åtkomsttoken för Jira, och skickar dem till Blob Storage. Skriptet stödde lagring av .txt-filer i Blob Storage, men på grund av problem med Cognitive Search fungerade .txt-filerna inte som de skulle. Därför skrev jag ett annat skript som konverterar .txt-filer till .pdf. Enligt min kontroll borde detta fungera, men eftersom .pdf-data fungerar har jag inte verifierat det med samma datamängd.
Jag laddade till slut upp 60 000 ärenden till systemet, vilket ledde till timeout i indexeraren med standardinställningarna. Som beskrivits ovan bör du därför först indexera en mindre batch och konfigurera indexerarens timeout-inställningar och cache innan du laddar upp stora mängder data. Då kan du också lagra datan i rätt ordning. Jag rekommenderar att du kör skript på någon server eller i en Azure Function.
Mitt skript tog sex timmar att köra mot Jira-servern. Antalet frågor per Jira-ärende är betydande, eftersom du först måste hämta data med JQL-frågan, sedan fråga efter ärendedetaljer för anpassade fält och detaljerad ärendeinformation, hämta kommentarer och, i mitt fall, hämta worklog-data från Tempo API. Med totalt tre API-anrop per ärende och paginering med 50 ärenden åt gången blev det omkring 200 000 API-anrop till Jira per körning av skriptet.
Efter att ha arbetat mer med OpenAI skulle jag kanske ändra detta till indexering per projekt, för att få bredare svar utifrån ett projektsammanhang i stället för ett ärendesammanhang. Ärendesammanhang ger ofta mycket specifika svar, vilket innebär att frågorna till OpenAI måste vara lika specifika. Jag har dock inte testat sökning på projektnivå.
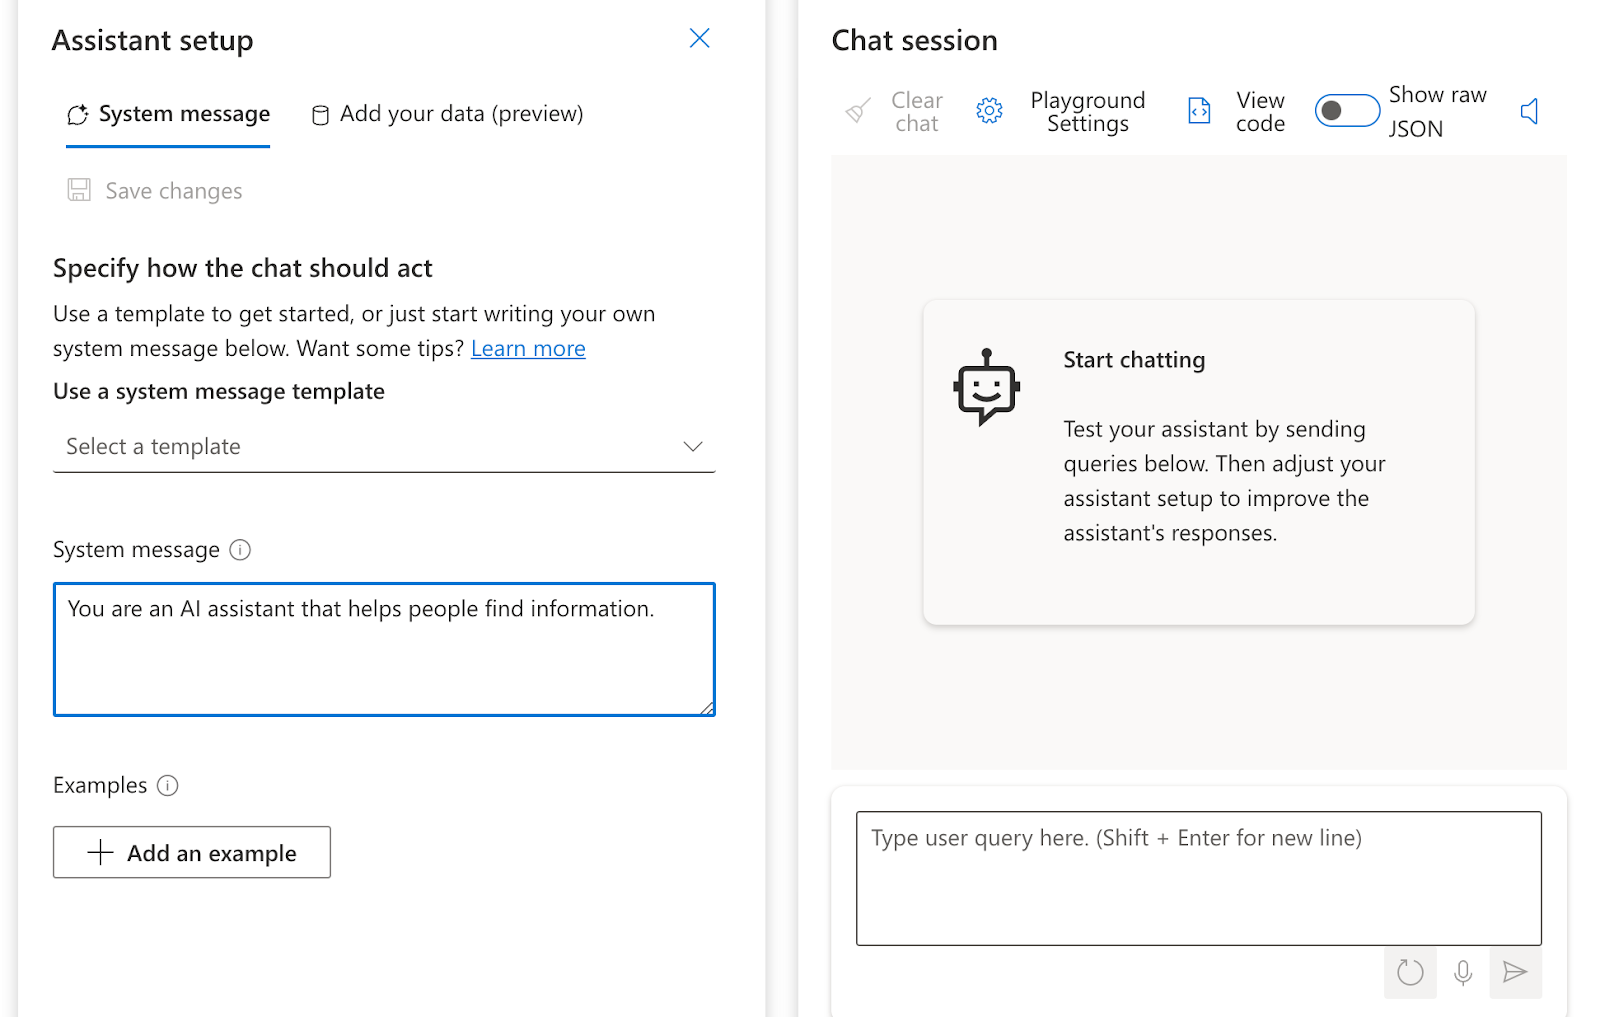
För att anpassa sökningen till din data kan du ändra systemmeddelandet så att det bättre passar din AI:s behov. Som standard står det: ”Du är en AI-assistent som hjälper människor att hitta information.” Det fungerar ganska bra i dessa användningsfall, men med bättre förberedande instruktioner kan du få bättre resultat. Om din AI inte fungerar som den ska, eller om du vill justera hur den svarar, kan en ändring här ha stor påverkan på resultatet. Vi har sett en oanvändbar bot bli fungerande.
Att göra Azure OpenAI Studio tillgängligt för min målgrupp
Nu har vi två olika chattfönster i Azure OpenAI Studio, och jag vill börja lansera dem. Först funderade jag på att ta koden som gränssnittet genererar automatiskt och bygga en Slackbot, men en kollega påpekade att Danswer kanske kunde vara en lösning eftersom det integreras automatiskt med Slack och Azure OpenAI.
Jag kom snabbt i gång med Danswer genom att distribuera det på min laptop med hjälp av deras snabbstartsguide och anpassade det för att använda Azure OpenAI för analys. Tyvärr stöder det för närvarande inte Azure Search som en av dokumentindexerarna, så jag kunde inte använda det för mitt användningsfall. Men uppmuntrad av hur långt lösningarna hade kommit tänkte jag: ”Kanske borde jag prova Microsofts knapp för snabbdistribution.” Tyvärr fungerar bot framework just nu bara för Teams, och eftersom vi för närvarande inte använder Teams för vår kommunikation bestämde jag mig för att prova att distribuera webbapplikationen. Det visade sig vara precis vad jag letade efter!
Du får ett mycket enkelt distributionsformulär, och efter 10–15 minuter har du ett fungerande chattfönster där Azure AD-autentisering blockerar obehörig användning och där du kan styra vem som får åtkomst till gränssnittet.
Jag fick ett mycket snabbt sätt att låta våra slutanvändare testa användningsfallen. (Se nedan hur du distribuerar applikationen. Observera att historikdata kräver CosmosDB, vilket innebär en kostnad på cirka 5 000 USD per månad. När du bygger ett business case rekommenderar jag att du i stället intervjuar slutanvändarna för att spara pengar, om du inte går direkt till produktion för hundratals personer.)

Fungerade mitt business case?
Fungerade det då? För att vara ärlig: enligt min bedömning, nej. Men ur slutanvändarnas perspektiv, ja, eftersom de har varit nöjda.

Vad händer nu? Via Azure Entra följer jag våra inloggningar och användningen av tjänsten för att förstå vilka av våra experter som använder den och varför. En av våra experter har tagit OpenAI-koden och arbetar med att integrera den i Jira för att klassificera de ärenden vi ser och förhoppningsvis skapa nya affärslösningar för oss. Vad fungerade? Det går snabbt att komma i gång med Azure OpenAI service, och med webbapplikationen kom jag till ”produktion” på nolltid för att testa datamängder tillsammans med våra experter.
Det jag hoppas kunna arbeta vidare med: dataformat och förberedande instruktioner för datan. Utifrån våra snabba genomgångar med experter fungerar lösningen bra inom specifika områden, men den ger ibland felaktig information på grund av felaktigt förberedd data eller antaganden som Azure OpenAI/LLM, till exempel ChatGPT, gör. Men sanningen är att det inte är en databas. Den sammanställer eller analyserar inte data, och den skapar inte färdiga rapporter. Det måste du göra på JQL-/databasnivå, eftersom det handlar om datasammanställningar. Däremot kan den förklara hur vi besvarade ett visst ärende förra gången.
Sammantaget är jag hoppfull och säker på att vi på sikt kan skapa värde för våra experter och kunder med detta. Men det är ingen universallösning och kräver tid och fokus för att förstå vad vi gör. Gott nytt år – förhoppningsvis känner du dig inspirerad att prova Azure OpenAI med din data.
- DevOps
- Eficode ROOT
- Atlassian
Subscribe to our newsletter
Related blogs


